Welk AI-model kies je voor je eerste video met een spreker?
Download de dia’s van de tutorial
Een bewerkbare Engelse PowerPoint-versie van deze tutorial.
8 dia’s · 2,5 MB
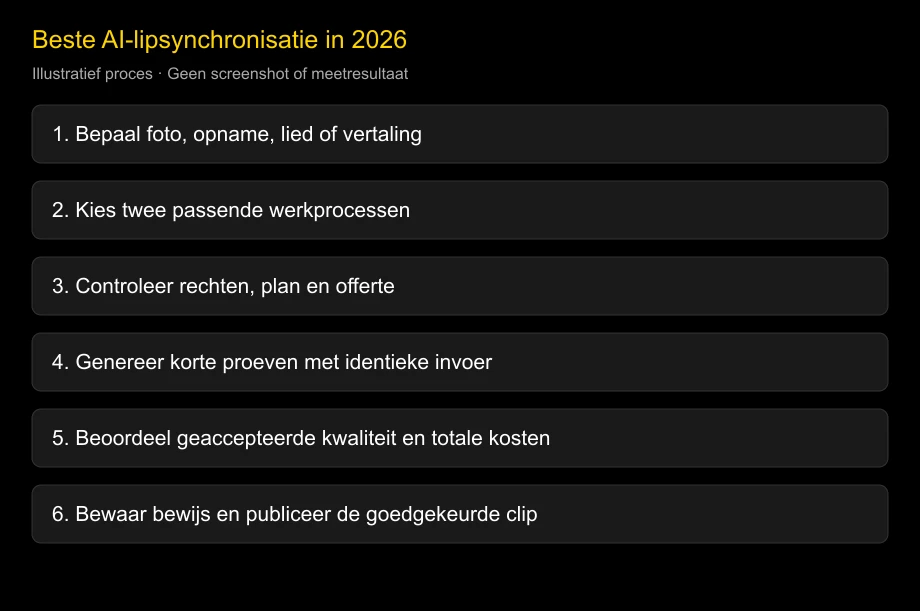
Download PowerPoint (Engels)Kies voor een cursusopening de pratende video die je goedgekeurde zin overbrengt op het formaat waarop hij wordt getoond. Werken beide versies, bewaar er dan één. Past geen van beide, beslis dan of je meteen de les laat zien of één gerichte wijziging maakt.
De twee voorbeelden van acht seconden hieronder zijn op 14 oktober 2026 voor LipSyncX gemaakt. Deze update van 5 november voegt een downloadbare besliskaart en gedateerde bestandsgegevens toe om je keuze te onderbouwen. Er is geen nieuwe rendertest toegevoegd en geen winnend model aangewezen.
Kan een foto een presentator voor een les worden?
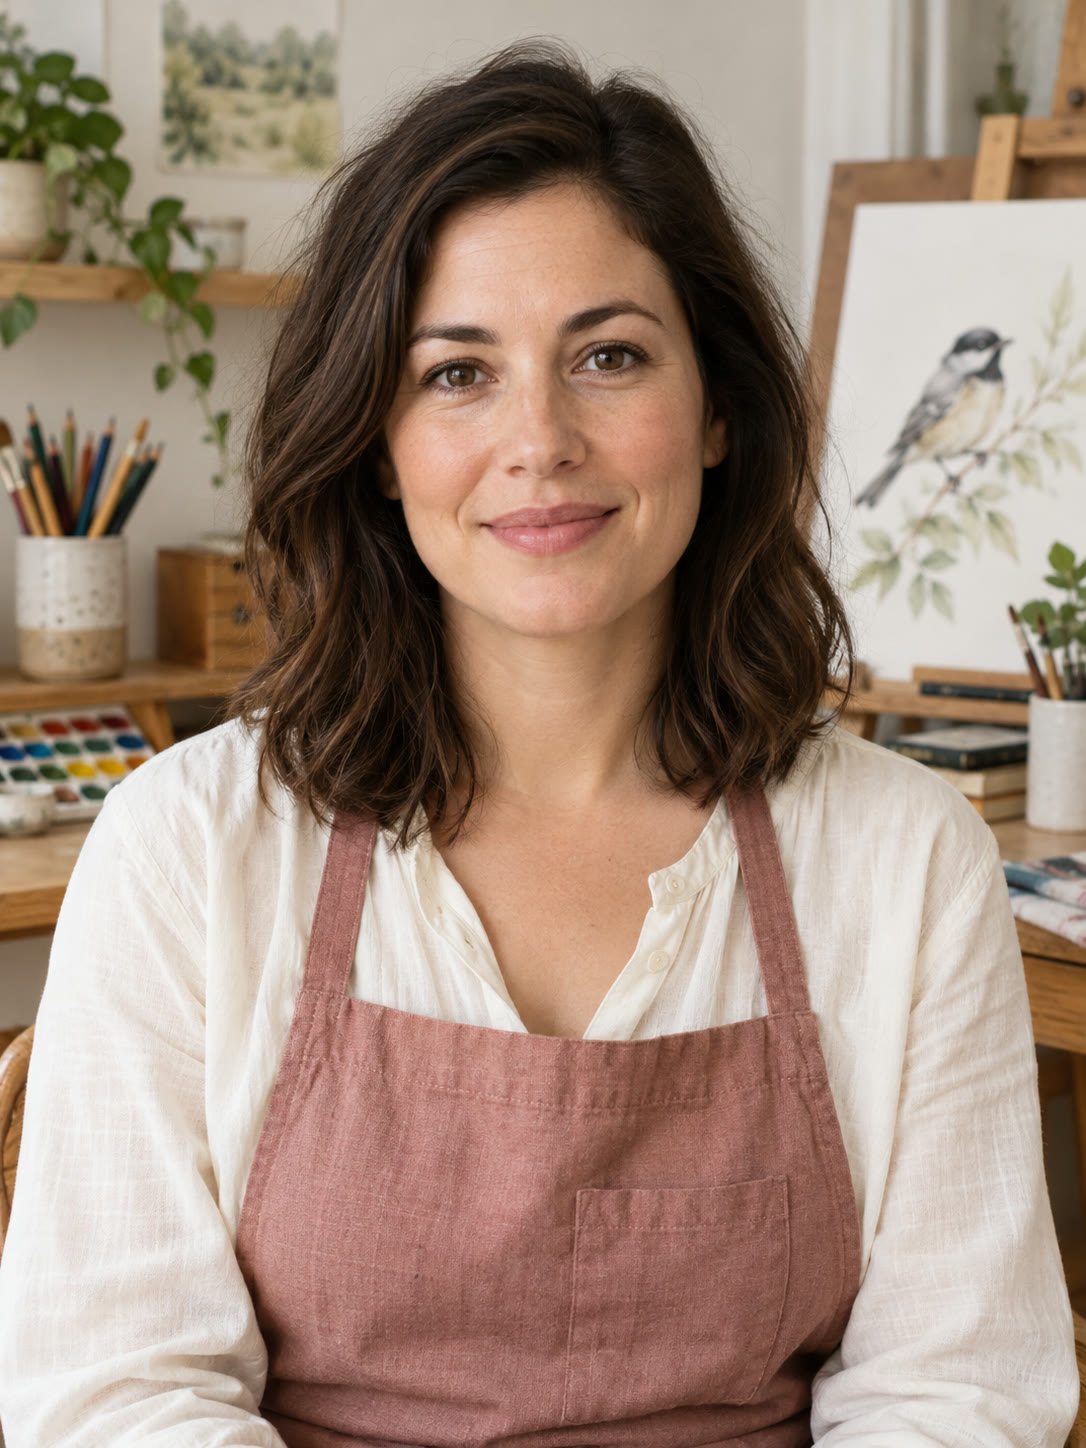
De invoer is een fictieve kunstdocent in een atelier. Het portret is gecombineerd met deze synthetisch uitgesproken Engelse lesopening:
Welcome to lesson three. You have already completed the first two exercises. Today, we will work on a new character design.
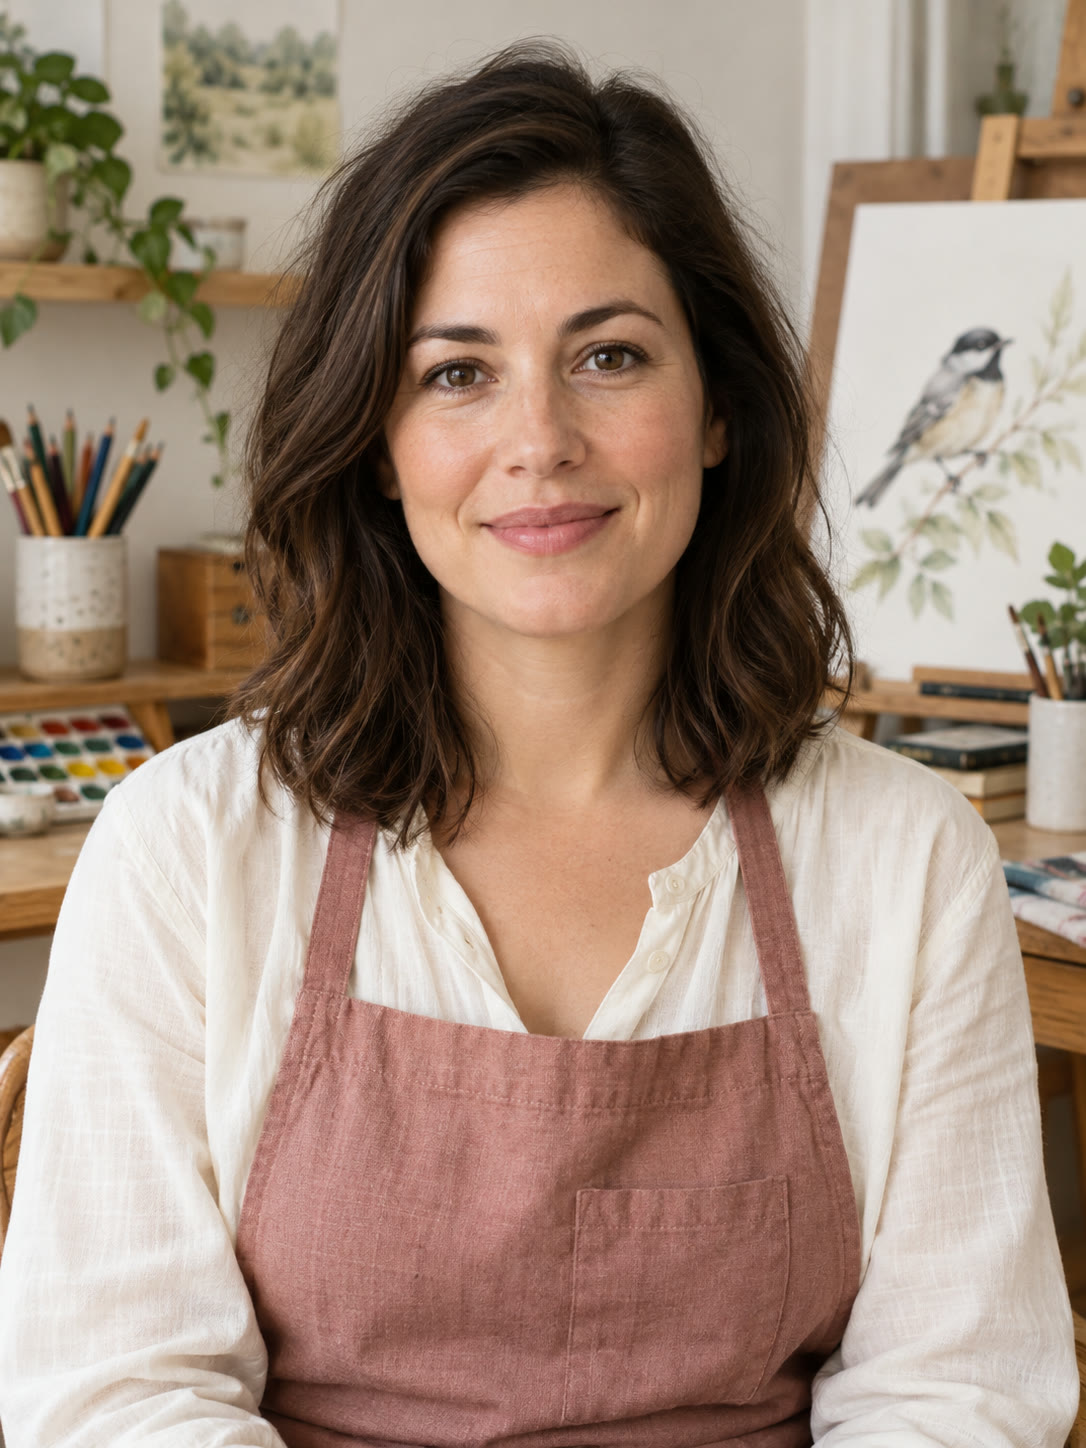
Een korte introductie door een presentator kan overgaan in een schermopname, productdemonstratie of lesdia. De rest van de video kan het werk laten zien.
De tool voor pratende foto’s accepteert een audio-upload. Je kunt ook met tekst beginnen als de gekozen werkwijze spraakgeneratie aanbiedt. Keur de opname goed voordat je het gezicht beoordeelt.
Vergelijk de twee volledige historische resultaten
Het verslag van 14 oktober noemt het eerste resultaat LipsyncX 2.0 Fast:
LipsyncX 2.0 Fast: de historische lesintroductie van acht seconden
Het tweede resultaat heet in dat verslag LipsyncX 2.0 Pro:
LipsyncX 2.0 Pro: hetzelfde historische portret en dezelfde vertelstem
Dit zijn de vastgelegde namen, geen actuele modelcatalogus. Het oorspronkelijke artikel vermeldt voor beide hetzelfde portret en dezelfde gesproken opname. Een afzonderlijk geüpload bronaudiobestand is niet beschikbaar voor een nieuwe hashcontrole. De presentator is door AI gegenereerd en de stem is synthetisch.
Bepaal wat je met de introductie doet
Download de lege besliskaart voor de plaatsing. Die bevat alleen een kopregel. Noteer de beoogde plaatsing, werkelijke weergavebreedte en acceptatievoorwaarde voordat je modellen vergelijkt. Voor een lesopening is een mogelijke voorwaarde dat de goedgekeurde zin volledig is en de presentator niet afleidt van de les. Dat is een voorgesteld criterium, geen oordeel over een van de voorbeelden.
Speel beide originelen op normale snelheid af onder dezelfde kijkconditie. Noteer het exacte woord, tijdstip en de bestandsnaam bij alles wat afleidt. Een groter beeld of een andere uitsnede geldt als een andere conditie. Een hash identificeert het beoordeelde bestand; hij beoordeelt geen natuurlijkheid.
| Beslissing | Wanneer die bij je beoordeling past | Wat je bewaart |
|---|---|---|
| De introductie accepteren | Voldoet aan de voorwaarde die je vóór de vergelijking opschreef | Geaccepteerd bestand en kijkconditie; geen verzonnen gebrek of verplichte nieuwe poging |
| Naar het werk knippen | De gesproken opname is goedgekeurd en de les of het product moet worden getoond | Gesproken aanknopingspunt voor de knip en controle van de gemonteerde export |
| Eén wijziging maken | Het origineel voldoet niet aan een benoemde voorwaarde die nog belangrijk is voor het shot | Woord/tijdstip, één invoerwijziging, actuele prijsopgave en vraag die een nieuwe poging zou beantwoorden |
Verschijnt het probleem alleen in de gemonteerde export, vergelijk die dan met de oorspronkelijke download voordat je opnieuw rendert. De gids voor probleemoplossing helpt de volgende controle te kiezen. Een acceptabele clip kun je bewaren zonder nog een poging af te dwingen.
De opzet van Magic Hour op 0:38–1:06 houdt de invoer van 15 seconden gelijk. Het kanaal verkoopt een vergeleken product; we gebruiken de methode, niet de leveranciersscores. In de uitleg van r4lph van 2 november op 0:14–0:35 veranderen de stem en mondrendering terwijl de avataranimatie behouden blijft. Dat is een vergelijking met verschillende audio. De beschrijving promoot Quant Alchemy-producten; de precieze sponsorvoorwaarden zijn onbekend.
Wat bewijzen de bestanden en afschrijvingen?
De CSV van de historische casus bevat twee feitelijke rijen. Plaatsing, acceptatiecriteria, woord/tijdstip-observaties en beslissingen blijven leeg. Ook oorspronkelijke prijsopgaven en geboekte creditteruggaven blijven leeg omdat die gegevens niet zijn vastgesteld.
| Vastgelegd voorbeeld | Audiolengte | Gekozen instelling | Op 14 oktober afgeschreven credits |
|---|---|---|---|
| LipsyncX 2.0 Fast | 8 seconden | 480p | 20 |
| LipsyncX 2.0 Pro | 8 seconden | 480p | 20 |
De gekozen instelling 480p staat los van de gemeten 544 × 720 pixels van de bestanden. Lokale bestandscontrole op 3 november kwam overeen met de bewaarde hashes van 28 oktober: elk origineel heeft 197 videoframes bij 25 fps, goed voor 7.88 seconden, met een audio-/containerduur van 8.00 seconden. Bestandskenmerken bewijzen geen kwaliteitsranglijst of generatiesnelheid.
De afschrijvingen van 20 credits zijn historisch, geen actuele prijsopgaven. Voor het paar zijn in totaal 40 credits afgeschreven. Kosten per bruikbare clip zijn niet gemeten omdat deze casuskaart geen acceptatiebeslissingen bevat. Heeft je eigen reeks nul bruikbare resultaten, bewaar dan de uitgaven en nul bruikbare clips; de kosten per stuk zijn ongedefinieerd. Trek alleen daadwerkelijk geboekte teruggaven voor die reeks af.
Controleer vóór een nieuwe inzending de actuele creditprijs en betaalvoorwaarden. Stel een stopbudget op met de exacte prijsopgave en het toegestane aantal pogingen. Het is je eigen plan, geen bestedingslimiet die het platform afdwingt.
Als het shot een andere werkwijze nodig heeft
Een gesprek tussen twee personen vraagt om een sprekersplan en een andere opzet; de interface voor pratende foto’s biedt Multi-opties. Deze voorbeelden met één presentator testen die werkwijze niet.
Begin voor een al gefilmde presentator met een andere stemtrack met de werkwijze voor lipsynchronisatie van video. Voor een cursusopening kun je na de presentator een schermopname laten volgen in plaats van het gezicht voortdurend in beeld te houden.
Veelgestelde vragen
Kan ik downloaden zonder het LipSyncX-watermerk?
Een geslaagde aankoop van extra credits ontgrendelt downloads zonder LipSyncX-watermerk voor bestaande en toekomstige video’s. Een nieuwe video genereren kost nog steeds credits. Controleer de actuele voorwaarden op de prijspagina.
Wat gebeurt er als een render mislukt?
Volgens het huidige prijsbeleid worden afgeschreven credits teruggezet op je saldo als een render bij de aanbieder mislukt. Dat is een teruggave van credits, los van een terugbetaling in geld. Een voltooide clip die je niet wilt gebruiken is een andere uitkomst.
Breng je beslissing in praktijk
Neem een portret en een goedgekeurde opname mee naar de LipSyncX-tool voor pratende foto’s. Controleer de gekozen werkwijze en prijsopgave en maak vervolgens een korte poging die één benoemde vraag beantwoordt. Bewaar het oorspronkelijke bestand en de besliskaart voordat je de invoer verandert.
Op 5 november 2026 met AI-schrijfhulp bijgewerkt voor LipSyncX. De resultaten, afschrijvingen en bestandsmetingen zijn hergebruikt bewijs. De beoordelingsstappen zijn aanbevelingen, geen nieuw geteste oplossingen.