
เครื่องมือสร้างภาพพูดออนไลน์: เลือกขั้นตอนให้ถูกต้อง
เครื่องมือสร้างภาพพูดออนไลน์รับภาพนิ่งหนึ่งภาพกับเสียงบันทึกหรือบทที่พิมพ์ แล้วสร้างวิดีโอที่ดูเหมือนใบหน้ากำลังพูด คุณไม่จำเป็นต้องมีวิดีโอต้นฉบับที่บุคคลนั้นพูด แต่ต้องมีภาพที่ได้รับอนุญาต เสียงที่เหมาะสม และขั้นตอนที่ระบุชัดว่ารองรับภาพนิ่งเป็นอินพุต
ตรวจสอบ: 2026-10-25 คู่มือนี้เปรียบเทียบเส้นทางตามเอกสารของ LipSyncX, D-ID, HeyGen และ sync-3 อธิบายวิธีเลือกและทดลองครั้งแรก ไม่ได้อ้างว่าเราทดสอบทั้งสี่ด้วยวัสดุเดียวกัน
ถ้ามีเพียงภาพบุคคล ให้เลือกขั้นตอนภาพเป็นวิดีโอพูด หากต้องรักษาการแสดงที่ถ่ายไว้ ให้เลือกซิงก์ปากวิดีโอเดิม
ภาพพูดคืออะไร?
ภาพพูดคือการเคลื่อนไหวที่สร้างจากภาพนิ่ง ระบบต้องสร้างรูปปาก และมักรวมการขยับกราม กะพริบตา สีหน้า หรือศีรษะ ภาพต้นฉบับให้รูปลักษณ์ แต่ไม่มีการแสดงที่บันทึกไว้
ดังนั้นการเลือกอินพุตจึงสำคัญ ภาพหน้าตรงชัดให้โมเดลเห็นอวัยวะใบหน้า ใบหน้าเล็กในภาพงานแต่งที่คนแน่น หรือภาพด้านข้างที่ผมบัง เป็นจุดเริ่มต้นที่ยากกว่า
ยังต่างจากสไลด์พร้อมเสียงบรรยายด้วย สไลด์คงภาพไว้ขณะเสียงเล่น ส่วนภาพพูดสร้างการออกเสียงที่มองเห็น จึงอาจมีข้อผิดพลาดด้านอัตลักษณ์และการเคลื่อนไหวที่ภาพนิ่งไม่มี
ต่างจากซิงก์ปากวิดีโออย่างไร?
| คำถาม | ภาพพูด | ซิงก์ปากวิดีโอเดิม |
|---|---|---|
| ต้นทาง | ภาพนิ่งหนึ่งภาพ | วิดีโอที่ถ่ายหรือสร้าง |
| การเคลื่อนไหว | ต้องสร้างจากภาพ | ปรับจากการแสดงที่เคลื่อนไหว |
| เป้าหมายทั่วไป | ผู้บรรยาย คำอวยพร คำอธิบายสั้น | เปลี่ยนประโยค พากย์สัมภาษณ์ แปลท้องถิ่น |
| ความเสี่ยงหลักตอนตรวจ | การเคลื่อนไหวที่แต่งขึ้นเปลี่ยนใบหน้า | การปรับรบกวนการแสดงเดิม |
ถ้าต้นทางเป็นผู้สอนที่ถ่ายไว้แล้ว ใช้เส้นทางพากย์วิดีโอ ถ้ามีภาพพนักงานกับข้อความต้อนรับที่อนุมัติแล้ว ใช้เส้นทางภาพพูด การเลือกอินพุตเริ่มต้นผิดอาจเพิ่มงานตัดต่อที่ไม่จำเป็น
ภาพร้องเพลงเป็นกรณีเกี่ยวข้องแต่แยกกัน โน้ตยาวและดนตรีต้องมีตัวอย่างของตน เครื่องมือที่ทำคำทักทายพูดได้น่าเชื่อไม่ได้พิสูจน์ว่าจะจับคู่ท่อนฮุกได้ดีด้วย
เลือกด้วยคำถามใช้งานจริงห้าข้อ
ใช้เสียงของตัวเองได้ไหม?
เสียงที่อัปโหลดช่วยให้อนุมัติจังหวะและการออกเสียงนอกเครื่องมือภาพ เหมาะเมื่อมีนักพากย์หรือเสียงบรรยายสำเร็จแล้ว ขั้นตอนพิมพ์บทสะดวกเมื่อไม่ต้องการใช้ไมโครโฟน
ตรวจว่าอัปโหลดเสียง เสียงในระบบ และโคลนเสียงอยู่ในโหมดเดียวกันหรือไม่ เป็นอินพุตต่างกันและอาจต้องใช้แพ็กเกจต่างกัน รายการเสียงสำเร็จรูปไม่ใช่หลักฐานว่าอัปโหลดเสียงของคุณได้
เครื่องมือรองรับภาพจริงของคุณหรือไม่?
ภาพคนจริง ภาพวาดคล้ายคน หน้าสัตว์เลี้ยง และตัวละครอนิเมะเป็นกรณีทดสอบต่างกัน หาเอกสารรองรับโมเดลชัดเจนแล้วทดลองสั้น อย่าเริ่มต้นกับแหล่งภาพแปลกด้วยการสร้างฉบับเต็มราคาแพง
เสียงพูดคำสำคัญถูกไหม?
ทดสอบแบรนด์ ชื่อคน ตัวเลข และศัพท์เทคนิค ฟังก่อนสร้างการเคลื่อนไหว หาก TTS ออกเสียงชื่อผลิตภัณฑ์ผิด ใบหน้าอาจซิงก์กับการออกเสียงที่ผิดได้อย่างดี
ส่งออกเวอร์ชันที่ต้องการได้หรือไม่?
บันทึกความละเอียด สัดส่วน ลายน้ำ ระยะเวลา และรูปแบบไฟล์ พรีวิวสำเร็จไม่พอหากดาวน์โหลดถูกจำกัดหรือครอปตัดคาง สำหรับโพสต์แนวตั้งให้ตรวจไฟล์ส่งออกขนาดหน้าจอโทรศัพท์
สิทธิ์ภาพ เสียง และผลลัพธ์เพียงพอหรือไม่?
สิทธิ์อัปโหลดภาพต่างจากสิทธิ์เลียนเสียง บัญชีเสียเงินไม่ได้อนุญาตให้ทำคนที่ไม่ยินยอมพูดคำใหม่ ตรวจสิทธิ์ต้นทางและเงื่อนไขผลลัพธ์เฉพาะก่อนเผยแพร่
รายการสั้นของเส้นทางภาพพูดออนไลน์
| เส้นทาง | จุดเริ่มต้นตามเอกสาร | ทางเสียงที่ควรศึกษา | ขอบเขตหลัก |
|---|---|---|---|
| LipSyncX | ภาพบุคคลพร้อมเสียงหรือข้อความ | อัปโหลดหรือสร้างเสียงพูด | ทดสอบโมเดลและค่าที่ให้ |
| D-ID Studio | ข้อความ เสียง และภาพนิ่ง | เสียง Studio หรือขั้นตอนเสียง | แยก Studio จาก Video Translate |
| อวตารภาพ HeyGen | ภาพเดียวกับเสียงหรือบท | บันทึก TTS หรือโคลนที่อนุญาต | ยืนยันโหมดและแพ็กเกจ |
| Sync sync-3 | การสร้างจากภาพเดียวที่อธิบายเดือนมิถุนายน 2026 | บท อัปโหลด หรือโคลน | อย่าสมมติว่าโมเดลเก่าเหมือนกัน |
ตารางจงใจไม่คัดจำนวนภาษาทั้งบริษัทใส่ทุกแถว การสร้างเสียง การแปล และแอนิเมชันปากอาจครอบคลุมภาษาต่างกัน ยืนยันเสียงและฟีเจอร์เฉพาะที่จะใช้
การเปิดเผย: LipSyncX เผยแพร่บทความนี้และให้บริการภาพพูดเชิงพาณิชย์ การเปรียบเทียบเกี่ยวกับอินพุตที่มีเอกสารและความเหมาะสมของขั้นตอน ไม่ใช่คะแนนความสมจริงอิสระ
LipSyncX: เริ่มด้วยภาพบุคคลและข้อความสั้น
เครื่องมือภาพพูด LipSyncX เป็นจุดเริ่มตรงสำหรับภาพบุคคลและคำพูดที่อนุมัติ ลองข้อความสั้นก่อนทำทั้งหลักสูตรหรือโฆษณา
ข้อดี: เริ่มจากภาพ/เสียงได้ชัดและมีตัวอย่างของผู้ให้บริการที่เก็บไว้ ข้อเสีย: ผลภาพเดียวที่ดีไม่พิสูจน์ความน่าเชื่อถือกับทุกใบหน้า สไตล์ ภาษา หรือเสียงยาว ตรวจราคาประเมินและไฟล์ส่งออกก่อนขยายงาน
D-ID: ศึกษาขั้นตอนอวตารที่มีโครงสร้าง
หน้า Studio ของ D-ID อธิบายข้อความ เสียง และภาพเป็นอินพุตวิดีโอที่มีอวตารนำเสนอ เหมาะกับผู้บรรยายคำอธิบายและทีมที่ใช้ขั้นตอนธุรกิจของบริการอยู่แล้ว
ข้อดี: การสร้างจากภาพเป็นเส้นทางผลิตภัณฑ์ที่ระบุชัด ข้อเสีย: ไม่ควรรวม Studio กับการแปลเป็นสิทธิ์เดียวที่คาดเอาเอง ตรวจสิทธิ์แพ็กเกจ เครื่องหมายแบรนด์ และไฟล์ส่งออกแยกกัน
HeyGen: ศึกษาพื้นที่สร้างงานที่กว้างกว่า
หน้าซิงก์ปาก HeyGen มีเส้นทางภาพพูดร่วมกับเครื่องมือวิดีโอถ่ายจริง อาจเหมาะกับทีมเล็กที่ต้องการบท เสียง หรือแปลท้องถิ่นในพื้นที่เดียว
ข้อดี: หลายช่วงงานใช้กระบวนการสร้างร่วมกันได้ ข้อเสีย: โมเดลและแพ็กเกจที่เกี่ยวข้องกำหนดขั้นตอนจริง หน้ารวมฟีเจอร์ไม่ได้ยืนยันประสิทธิภาพเท่ากันกับทุกอินพุต
Sync: แยก sync-3 จากสมมติฐานเกี่ยวกับโมเดลเก่า
คู่มือภาพเดียวของ Sync ลงวันที่ 21 มิถุนายน 2026 อธิบาย sync-3 สร้างการเคลื่อนไหวจากภาพนิ่ง และกล่าวถึงภาพวาดตัวละครที่มองแล้วอ่านเป็นมนุษย์ได้
ข้อดี: มีคำอธิบายรองรับภาพเดียวสำหรับโมเดลนั้นชัดเจน ข้อเสีย: การใช้ข้ออ้างนี้กับทุกโมเดล Sync ในอดีตหรือตัวละครไม่ใช่มนุษย์ใดๆ จะทำให้เข้าใจผิด ตรวจโมเดลที่แน่นอนในบัญชีก่อนส่ง
ดูภาพกว้างจากรายชื่อเครื่องมือ เลือกสองเส้นทางที่อินพุตตรงกัน แทนเทียบเครื่องมือภาพกับขั้นตอนวิดีโอถ่ายจริงที่ต้องการต้นทางคนละชนิด
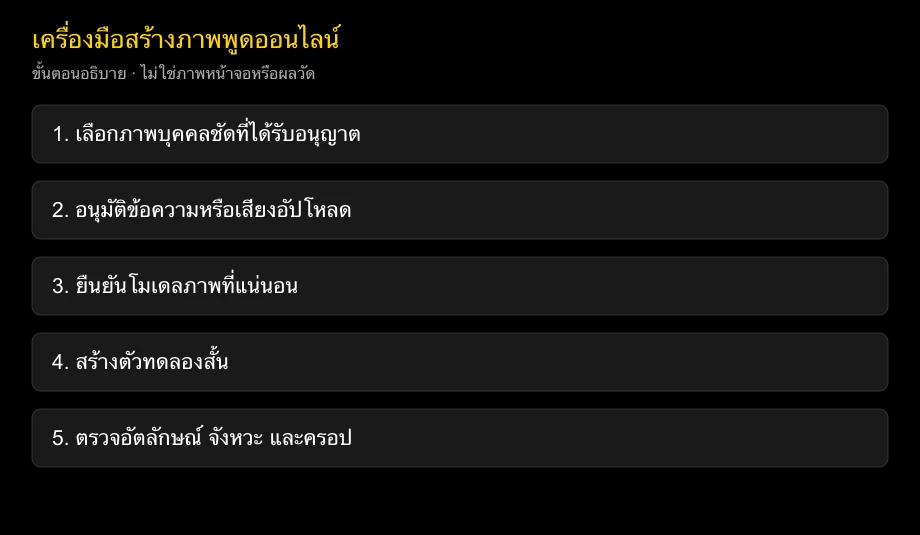
ทำคลิปแรกในสี่ขั้นตอน
- เตรียมภาพ ใช้ใบหน้าเดียวชัด เห็นคางครบและไหล่เพียงพอ เก็บไฟล์ต้นฉบับ เลี่ยงภาพหน้าจอบีบอัดหนักเมื่อมีแหล่งดีกว่า
- เตรียมเสียง เขียนข้อความสั้นหรืออัปโหลดเสียงที่อนุมัติ ฟังชื่อ จังหวะ และท้ายประโยคก่อนสร้างใบหน้า
- สร้างตัวทดลอง ตรวจโมเดล ขนาด ราคาตามระยะเวลา และเงื่อนไขส่งออก เก็บค่าพร้อมไฟล์ต้นทาง
- ตรวจและส่งออก ดูความเร็วปกติ ตรวจเวลาในช่วงยาก และยืนยันครอปสุดท้าย เก็บฉบับอนุมัติแยกจากครั้งที่ปฏิเสธ
การทดลองสิบวินาทีเป็นคำแนะนำด้านบรรณาธิการ ไม่ใช่ขีดจำกัดอัปโหลดสากล ยาวพอสำหรับวลี ช่วงหยุด และจบ โดยไม่ทำให้การแก้แรกทุกครั้งแพง หากการออกเสียงสำคัญให้ใช้เนื้อหาจริงแทนประโยคเดโมทั่วไป
ถ้ายังไม่มีเสียง ตามคู่มือภาพจากข้อความเป็นเสียง ขั้นตอนนี้แยกอนุมัติเสียงจากสร้างการเคลื่อนไหว เพื่อไม่ให้เปลี่ยนบทแล้วต้องสร้างใหม่โดยไม่จำเป็น
มีเพียงภาพบุคคลทำอะไรได้บ้าง?
สำหรับต้อนรับพนักงานใหม่ ใช้คนที่ยินยอมต่อข้อความและวัตถุประสงค์ บทแรกที่มีประโยชน์อาจเป็น “ยินดีต้อนรับสู่ทีม เปิดเช็กลิสต์แล้วเลือกงานแรก” ตรวจวลีสุดท้ายอย่างละเอียดเท่าตอนเริ่ม
สำหรับอธิบายผลิตภัณฑ์ ให้ช่วงภาพบุคคลสั้นแล้วตัดไปผลิตภัณฑ์จริง ผู้พูดไม่ต้องอยู่ทุกวินาทีของวิดีโอสุดท้าย การสาธิตระยะใกล้หรือบันทึกหน้าจออาจถ่ายทอดรายละเอียดได้ชัดกว่าใบหน้า
สำหรับคำอวยพร ใช้ข้อความต้นฉบับสั้นและภาพที่ได้รับอนุญาต หากอัปโหลดภาพผู้รับแบบเซอร์ไพรส์ ให้คิดว่าพวกเขาจะคาดหวังการใช้นั้นอย่างสมเหตุสมผลหรือไม่ การอนุญาตเป็นอินพุตการผลิต ไม่ใช่รายละเอียดไว้จัดการหลังเรนเดอร์
ใช้ภาพประวัติศาสตร์หรือภาพวาดได้ไหม?
สถานะลิขสิทธิ์ภาพประวัติศาสตร์อาจต่างจากสิทธิ์รูปลักษณ์ของบุคคลหรือเสียงที่เกี่ยวข้อง ตรวจสิทธิ์ภาพและอย่านำเสนอคำพูดที่สร้างเป็นบันทึกที่ค้นพบ ติดป้ายการจำลองชัดเมื่อผู้ชมอาจคิดว่าเป็นวัสดุจริง
ภาพวาดอาจไม่เป็นไปตามเรขาคณิตใบหน้ามนุษย์ปกติ ปากเล็ก ตาผิดปกติ หรือด้านข้างแบนอาจทำให้เกิดฟันที่แต่งขึ้นหรือการเคลื่อนไหวไม่นิ่ง ใช้โมเดลที่ระบุอินพุตนั้นโดยเฉพาะและประเมินเป็นแอนิเมชันมีสไตล์
หน้าสัตว์เลี้ยงเพิ่มปัญหาเรขาคณิตอีกแบบ อย่าสมมติว่าเครื่องมือรับตัวละครคล้ายคนจะรองรับปากยื่นของสุนัขด้วย ต้องทดลองสั้น และไม่ควรเรียกผลน่ารักสนุกว่าเป็นหลักฐานการพูดมนุษย์สมจริง
อะไรทำให้ภาพพูดดูผิด?
ปัญหาพบบ่อยคือคางถูกตัด ปากถูกบัง สีหน้าเกินจริง และเสียงเร็วเกินไป ทำการทดสอบแรกให้เรียบง่าย: หน้าเดียว เสียงพูดสะอาด การแสดงพอดี และภาพชัด
ถ้าใบหน้าเปลี่ยนอัตลักษณ์ ให้ปฏิเสธไฟล์ส่งออกแล้วลองแหล่งดีกว่าหรือเส้นทางอื่น ถ้าเสียงเร่งให้เขียนประโยคใหม่ ถ้าปากขยับช่วงเงียบ ให้จดเวลาเสียและตรวจค่าจังหวะหรือโมเดล
ตรวจทั้งใบหน้าและคอ ไม่ใช่แค่ริมฝีปาก ฟันกะพริบ ขนหน้าเลื่อน และแว่นไม่นิ่งรบกวนได้แม้พยางค์ตรงกัน ภาพหน้าจอนิ่งไม่ยืนยันว่าการเคลื่อนไหวยอมรับได้
เก็บต้นทางและการตัดสินใจไว้ด้วยกัน
เก็บภาพ เสียงที่อนุมัติ ข้อความ โมเดล วันที่ ราคาประเมิน ค่าตั้ง และไฟล์สุดท้าย ชุดหลักฐานเล็กนี้ช่วยทำซ้ำคลิปที่สำเร็จหรือวิเคราะห์ข้อผิดพลาดภายหลัง อีกทั้งป้องกันนำบทแก้ไขไปจับคู่เสียงเก่าโดยบังเอิญ
สำหรับงานหลายภาษา เพิ่มการอนุมัติจากผู้ตรวจเจ้าของภาษาในแต่ละภาษา ตัวเลือกภาษาไม่พอตรวจการออกเสียง แยกอนุมัติคำแปลจากภาพเพื่อรู้ว่าช่วงใดต้องแก้
คำถามที่พบบ่อย
ต้องมีวิดีโอต้นฉบับเพื่อทำภาพพูดหรือไม่?
ไม่ต้อง ขั้นตอนภาพพูดจริงสร้างการเคลื่อนไหวจากภาพนิ่ง ซิงก์ปากวิดีโอเดิมเป็นอีกเส้นทางที่เริ่มจากฟุตเทจ
ภาพพูดใช้เสียงฉันได้ไหม?
มักได้เมื่อเครื่องมือรองรับอัปโหลดเสียงบันทึก ยืนยันฟีเจอร์เฉพาะและใช้เสียงที่คุณได้รับอนุญาตให้อัปโหลดและเผยแพร่
ออนไลน์แปลว่าไม่มีอะไรถูกอัปโหลดหรือไม่?
ไม่ใช่ ขั้นตอนเบราว์เซอร์มักส่งไฟล์ไปบริการเพื่อประมวลผล ตรวจเงื่อนไขความเป็นส่วนตัวและเก็บรักษาก่อนอัปโหลดใบหน้าหรือเสียงอ่อนไหว
ทำบทเรียนเต็มจากภาพเดียวได้ไหม?
อาจได้ตามผลิตภัณฑ์และขีดจำกัดระยะเวลา แต่ควรทดลองช่วงสั้นก่อน บทเรียนยาวควรผสมคลิปผู้บรรยายกับการสาธิตที่มีประโยชน์และตรวจความต่อเนื่องระหว่างช่วง
ภาพพูดเหมือนโคลนเสียงหรือไม่?
ไม่เหมือน ขั้นตอนภาพสร้างการเคลื่อนไหวที่เห็น ส่วนโคลนเสียงสร้างหรือเลียนเสียง ต้องมีการอนุญาตและฟีเจอร์รองรับของตนเอง
เริ่มจากข้อความมีประโยชน์ที่สั้นที่สุด
นำภาพบุคคลที่อนุญาตหนึ่งภาพและบทสองประโยคไปที่เครื่องมือภาพพูด อนุมัติเสียง สร้างทดลองสั้น และตรวจด้วยครอปตรงที่จะเผยแพร่
บันทึกการเปลี่ยนแปลง
- 2026-10-25: ตรวจเส้นทางภาพทางการของ D-ID, HeyGen และ Sync เพิ่มขอบเขตเฉพาะโมเดล การทดลองสี่ขั้นตอน และการตรวจแยกภาพประวัติศาสตร์ ภาพวาด เสียง และไฟล์ส่งออก