
ทำให้ภาพพูดด้วยข้อความเป็นเสียง: ไม่ต้องใช้ไมโครโฟน
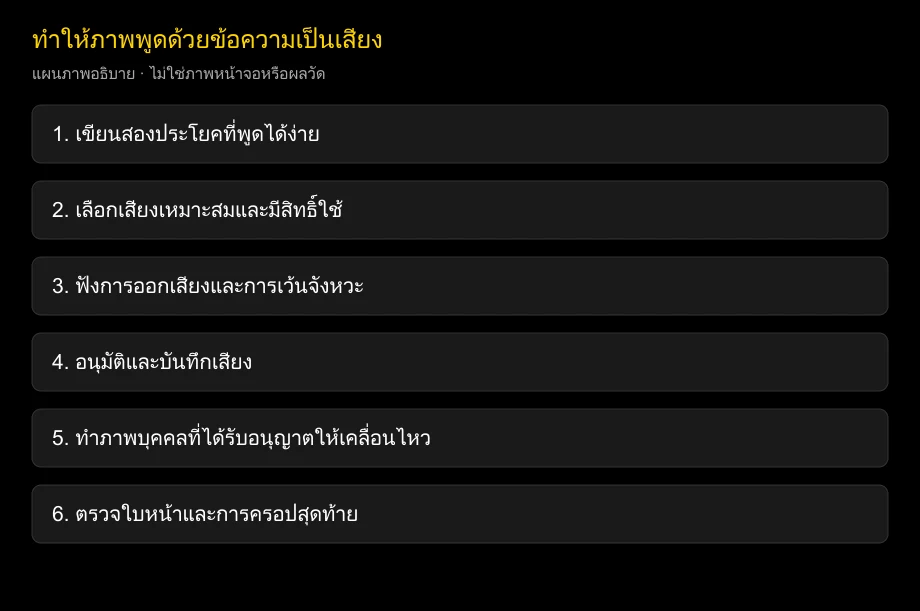
ได้ คุณทำให้ภาพพูดด้วยการแปลงข้อความเป็นเสียงได้โดยไม่ต้องอัดเสียงตัวเอง เขียนบท สร้างและอนุมัติเสียงที่มีสิทธิ์ใช้ แล้วนำเสียงไปใช้กับเครื่องมือเปลี่ยนภาพเป็นวิดีโอพูด บางแพลตฟอร์มรวมทั้งสามขั้น แต่การตรวจเสียงก่อนสร้างใบหน้าช่วยเลี่ยงการสร้างซ้ำที่ไม่จำเป็น
ตรวจสอบ: 2026-10-25 คู่มือนี้ทบทวนข้อมูลทางการของ D-ID, HeyGen, Sync และ ElevenLabs ภาษาและการควบคุมช่วงหยุดขึ้นกับโมเดลเสียงที่เลือก ไม่ควรอนุมานจากข้อความโฆษณารวมของบริษัท
ลำดับที่เชื่อถือได้คือบท เสียง แล้วจึงใบหน้า ปากที่ตรงเสียงยังอาจออกเสียงผิด จึงควรอนุมัติเสียงก่อนตัดสินภาพเคลื่อนไหว
ต้องเตรียมอะไรก่อนเริ่ม
เตรียมภาพบุคคลที่ได้รับอนุญาต บทสั้น และเสียงที่ใช้ได้ตามวัตถุประสงค์ ใบหน้าตรงชัดเจนและปากไม่ถูกบังเหมาะกับการทดสอบแรก เก็บคางครบและพื้นที่รอบภาพสำหรับครอปขั้นสุดท้าย
การแปลงข้อความเป็นเสียงทั่วไปไม่ต้องมีไมโครโฟน การโคลนเสียงเป็นทางเลือกและต้องขอความยินยอมเพิ่ม หากไม่จำเป็นต้องเลียนแบบบุคคลเฉพาะ เสียงสำเร็จรูปหรือเสียงที่ออกแบบก็อาจเหมาะสม
เก็บภาพต้นฉบับ ข้อความ เสียงสุดท้าย และการตั้งค่าร่วมกัน เมื่อเปลี่ยนคำให้บันทึกเสียงเวอร์ชันใหม่แทนการเขียนทับเก่า จะช่วยไม่ให้ซับใหม่จับคู่กับเสียงเก่า
ทำให้ภาพพูดในสามขั้นตอน
1. เขียนเพื่อฟัง ไม่ใช่เพื่ออ่าน
หนึ่งแนวคิดต่อหนึ่งประโยค และบอกการกระทำหลักตั้งแต่ต้น อ่านออกเสียงแม้สุดท้ายจะใช้เสียงสังเคราะห์ หากคุณต้องหยุดเพื่อเข้าใจถ้อยคำของตัวเอง ผู้ฟังก็อาจต้องหยุดเช่นกัน
บทแรกประมาณสองประโยคสั้นกำลังดี เช่น “ยินดีต้อนรับสู่พื้นที่ทำงาน เปิดรายการตรวจสอบแล้วเลือกงานแรก” นี่คือตัวอย่างบทที่เขียนขึ้น ไม่ใช่ผลลัพธ์ผลิตภัณฑ์ที่บันทึกเสียงไว้
เขียนตัวเลขหรือตัวย่อเป็นคำเมื่อเสียงอ่านผิด ทดสอบชื่อแบรนด์และคนจริงก่อนเขียนบทเต็ม เสียงที่อ่านอังกฤษทั่วไปดีอาจยังต้องช่วยกับชื่อผลิตภัณฑ์หรือประโยคผสมภาษา
2. สร้างและอนุมัติเสียง
เลือกเสียงให้เหมาะผู้ฟังและภาษา ฟังโดยไม่ดูใบหน้า ตรวจการออกเสียง จังหวะ อารมณ์ และคำสุดท้าย แล้วค่อยปรับข้อความหรือการตั้งค่าที่รองรับ
บันทึกเสียงที่อนุมัติก่อนสร้างภาพเคลื่อนไหว ถ้าแพลตฟอร์มรวมขั้นตอนและมีเสียงตัวอย่างให้ใช้ ถ้าไม่มี ให้เริ่มคลิปสั้นเพื่อไม่ต้องสร้างวิดีโอยาวใหม่เพราะแก้คำเล็กน้อย
3. ทำภาพบุคคลเคลื่อนไหวและตรวจไฟล์ส่งออก
อัปโหลดเสียงที่อนุมัติเข้ากระบวนการภาพพูด หรือใช้ช่องบทที่แพลตฟอร์มรองรับ ตรวจโมเดล ระยะเวลาตามราคา การครอป และเงื่อนไขส่งออก บันทึกค่าร่วมกับไฟล์ต้นทาง
ดูด้วยความเร็วปกติ ตรวจวลีแรก ช่วงหยุด และการปิดปากสุดท้าย แล้วดูทั้งใบหน้าและคอ หากตัวตนเปลี่ยน ลองภาพชัดกว่าหรือวิธีอื่นแทนการสรุปว่าเสียงเป็นต้นเหตุ
ปรับบทการตลาดก่อนสร้าง
เปรียบเทียบตัวอย่างที่เขียนขึ้นต่อไปนี้:
| ร่าง | เวอร์ชันพูด | ประโยชน์จากการแก้ |
|---|---|---|
| แพลตฟอร์มของเราช่วยเพิ่มประสิทธิภาพกระบวนงานอย่างครอบคลุม | ใส่งานถัดไปของทีมไว้ในรายการร่วมเดียวกัน | บอกการกระทำที่ชัดเจน |
| โปรดไปยังส่วนการตั้งค่าเพื่อดำเนินการต่อ | เปิดการตั้งค่า จากนั้นเลือกภาษา | แบ่งช่วงประโยคชัด |
| ประหยัด 20% ก่อน 10/31 | ประหยัดยี่สิบเปอร์เซ็นต์ก่อนวันที่สามสิบเอ็ดตุลาคม | ลดความกำกวมในการอ่านตัวเลข |
นี่เป็นตัวอย่างการเขียน ไม่ได้หมายความว่าทุกเสียงต้องเขียนตัวเลขเป็นคำ ฟังผลจริงและเก็บเวอร์ชันที่สื่อความหมายตรง ชัด และเป็นธรรมชาติ
บทแนะนำผลิตภัณฑ์สั้นใช้สามส่วนได้: ช่วยใคร งานที่ต้องทำตอนนี้ และขั้นถัดไป เช่น “ดูแลชั้นเรียนเล็กอยู่ไหม รวมรายการบทเรียนไว้ที่เดียว เปิดเทมเพลตแล้วเพิ่มกิจกรรมแรก” ให้ช่วงภาพบุคคลสั้นพอที่การสาธิตผลิตภัณฑ์จะอธิบายรายละเอียด
ถ้ามีเสียงสำเร็จแล้ว ข้าม TTS และนำไฟล์ไปใช้ในเครื่องมือภาพพูด เป้าหมายคืออนุมัติเสียง ไม่ใช่บังคับทุกโครงการให้ผ่านเสียงสังเคราะห์
ควรเพิ่มช่วงหยุดอย่างไร
เริ่มจากเครื่องหมายวรรคตอนปกติ จุดมักทำให้แบ่งช่วงชัดกว่าจุลภาค แต่การพูดจริงขึ้นกับโมเดล ประโยคสั้นแก้ง่ายกว่าบรรทัดยาวที่เต็มไปด้วยสัญลักษณ์หยุด
บางระบบรองรับช่วงหยุด SSML แท็กเสียง หรือการควบคุมอื่น อย่าคิดว่าใช้ไวยากรณ์แทนกันได้ คำสั่งของโมเดลหนึ่งอาจถูกละเลยหรือถูกอีกโมเดลอ่านออกเสียง
เอกสาร TTS ของ ElevenLabs แยกโมเดลและความสามารถ อ่านเอกสารของโมเดลที่ใช้ก่อนใส่แท็ก หากมีตัวควบคุมช่วงหยุดเฉพาะ ให้ลองฟังสั้นๆ แล้วเก็บผลที่อนุมัติ
ตัวอย่างข้อความธรรมดา “เปิดการตั้งค่า จากนั้นเลือกภาษา” เป็นจุดเริ่มต้นที่นำไปใช้ได้ทั่วไป แท็กอย่าง <break time="500ms"/> เหมาะเฉพาะระบบที่ระบุรองรับ SSML รูปแบบนั้นอย่างชัดเจน ตัวอย่างขอหยุดครึ่งวินาที ไม่ใช่คำสั่งที่ใช้ได้ทุกระบบ
ควรใช้เส้นทางเครื่องมือใด
| สถานการณ์เริ่มต้น | เส้นทางที่ควรศึกษา | ขอบเขตหลัก |
|---|---|---|
| มีบทกับภาพแต่ไม่มีเสียง | ภาพพูดที่รวมการป้อนข้อความ | ฟังเสียงและตรวจโมเดล |
| มีเสียง TTS ภายนอกที่อนุมัติแล้ว | อัปโหลดเสียงเข้าตัวทำภาพพูด | รักษาเวลาที่ตรงและสิทธิ์เสียง |
| ต้องการเสียงส่วนบุคคลที่จำได้ | โคลนที่อนุญาตพร้อมภาพเคลื่อนไหว | ขอความยินยอมเสียงและรูปลักษณ์แยกกัน |
| ต้องการหลายภาษา | บทที่เจ้าของภาษาตรวจและเสียงแต่ละภาษา | มีให้ใช้ไม่ได้แปลว่าคุณภาพเท่ากัน |
หน้า Studio ของ D-ID อธิบายข้อความ เสียง และภาพนิ่งสำหรับวิดีโออวตาร หน้าลิปซิงก์ HeyGen มีบทพิมพ์และอวตารจากภาพนอกเหนือจากวิดีโอเดิม คู่มือภาพ Sync อธิบายตัวเลือกบทและเสียงสำหรับ sync-3
ข้อมูลทางการเป็นเหตุผลให้ศึกษาเส้นทาง แต่ไม่ใช่หลักฐานเปรียบเทียบความสมจริง การเปิดเผย: LipSyncX เผยแพร่บทความและให้บริการกระบวนการภาพพูดเชิงพาณิชย์ ไม่ได้อ้างอันดับคุณภาพอิสระจากอินพุตเดียวกัน
จำนวนภาษาหมายถึงอะไร
การรองรับขึ้นกับโมเดล เอกสาร ElevenLabs ที่ตรวจวันที่ 25 ตุลาคม 2026 ระบุ Flash v2.5 รองรับ 32 ภาษาและ Multilingual v2 รองรับ 29 ขณะที่รุ่นใหม่มีจำนวนต่างกัน บันทึกโมเดลจริงแทนการบอกว่าทุกเสียงได้จำนวนสูงสุดในโฆษณา
แพลตฟอร์มวิดีโอก็ต้องระวังเช่นกัน ภาษาที่ใช้กับเสียงอัปโหลด การแปล หรือเสียงสำเร็จ อาจไม่มีในโหมดโคลนหรืออวตารทุกแบบ ตรวจชุดที่ต้องการในกระบวนการจริง
เนื้อหาหลายภาษาควรให้เจ้าของภาษาอนุมัติข้อความและฟังเสียง ใส่ชื่อ วันที่ และศัพท์เทคนิคในคลิปลอง ปากที่ดูน่าเชื่อไม่ได้พิสูจน์คำแปลถูกต้อง
แยกสิทธิ์เสียงออกจากสิทธิ์รูปลักษณ์
บางคนยอมให้แสดงภาพ แต่ไม่ได้ยอมให้มีคำพูดใหม่ในนามตน นักพากย์อาจให้ใช้บันทึกแต่ไม่อนุญาตโคลน ระบุเป้าหมาย การเผยแพร่ ระยะเวลา และขอบเขตเชิงพาณิชย์ก่อนสร้างให้ลูกค้า
เสียงโคลนที่จำได้ต้องมีอนุญาตชัดจากบุคคลหรือผู้ถือสิทธิ์ที่มีอำนาจ เก็บความยินยอมกับแหล่งข้อมูลและช่องทางติดต่อแก้ไขหรือถอน อย่าทำให้เข้าใจว่าคำพูดที่สร้างเป็นบันทึกจริง
ตรวจข้อกำหนดและการใช้ข้อมูลของเครื่องมือด้วย โดยทั่วไปเครื่องมือเว็บอัปโหลดไฟล์ และกฎลบหรือฝึกอาจต่างตามแพ็กเกจ งานละเอียดอ่อนหรือรับเงินควรดูความปลอดภัยอัปโหลดใบหน้า, การฝึกและเก็บข้อมูล และการใช้เชิงพาณิชย์
แก้ขั้นตอนที่มีปัญหา
หากชื่อผลิตภัณฑ์ผิด ให้แก้หรือสร้างเสียงใหม่ ถ้าชัดแต่เร็วเกิน ให้ลดบทหรือใช้ตัวควบคุมจังหวะที่รองรับ ถ้าหน้าเปลี่ยนหรือฟันกะพริบ ให้ตรวจภาพและโมเดลภาพ
หากปากขยับตอนหยุด ให้เก็บเวลาแล้วดูตัวเลือกเวลาและโมเดล ถ้าคำท้ายถูกตัด ให้เทียบความยาวเสียง คลิปที่ส่ง และไฟล์ส่งออก อย่าเปลี่ยนหลายตัวแปรพร้อมกันเพราะไม่รู้ว่าอะไรช่วย
คลิปลองสั้นทำให้งานจัดการได้ เก็บครั้งที่ไม่ผ่านเป็นหลักฐาน และเก็บเสียงกับค่าที่อนุมัติ โครงการใหญ่ใช้รายชื่อเครื่องมือ หาวิธีอื่นที่เหมาะโดยไม่ต้องเริ่มเขียนบทใหม่ทั้งหมด
คำถามที่พบบ่อย
ทำให้ภาพพูดจากข้อความโดยไม่ใช้ไมโครโฟนได้ไหม
ได้ สร้างเสียงสังเคราะห์ที่มีสิทธิ์จากบท แล้วทำภาพเคลื่อนไหวด้วยเสียงหรือช่องข้อความแบบรวม
จำเป็นต้องโคลนเสียงตัวเองหรือไม่
ไม่จำเป็น เสียงสำเร็จหรือเสียงที่ออกแบบใช้ได้ การโคลนเป็นทางเลือกและต้องมีสิทธิ์กับฟีเจอร์แยก
ใส่ SSML ในทุกช่องข้อความได้ไหม
ไม่ได้ ใช้ SSML หรือแท็กเฉพาะเมื่อระบบและโมเดลนั้นระบุรองรับ มิฉะนั้นเริ่มด้วยข้อความและเครื่องหมายวรรคตอนทั่วไป
แปลบทแล้วเวลาจะเท่าเดิมไหม
ไม่เสมอ แต่ละภาษามีความยาววลีและจังหวะต่างกัน อนุมัติข้อความที่พูดได้ดีและวัดเสียงจริงก่อนสร้างหน้า
ใบหน้าสมจริงทำให้เสียงเป็นธรรมชาติกว่าไหม
อาจเปลี่ยนความรู้สึกแต่ไม่แก้การออกเสียงหรือจังหวะ ฟังเสียงอย่างเดียวก่อนดูภาพเคลื่อนไหว
อนุมัติสองประโยคก่อนทำภาพเคลื่อนไหว
เขียนข้อความสั้นที่มีชื่อและตัวเลขจริงซึ่งผู้ฟังต้องการ นำไปที่เครื่องมือภาพพูด ฟังเสียง และสร้างคลิปบุคคลสั้นเมื่อเสียงพูดตรงตามเจตนาแล้วเท่านั้น
บันทึกการเปลี่ยนแปลง
- 2026-10-25: ตรวจเส้นทางข้อความ เสียง ภาพทางการและภาษาของ TTS ตามโมเดล เพิ่มตัวอย่างบทพูด คำแนะนำ SSML แบบมีเงื่อนไข และการตรวจสิทธิ์เสียงกับรูปลักษณ์แยกกัน