
在线说话照片生成器:选对图片转视频路径
在线说话照片生成器接收一张静态图和一段声音或文字脚本,生成脸部看似在说话的视频。不需要这个人原本开口说话的录像,但需要获授权图片、适合音频,以及明确支持静态图输入的流程。
核查日期:2026-10-25。 本文比较 LipSyncX、D-ID、HeyGen 和 sync-3 的文档路径,说明选型与首次试做方法,并不声称已用相同素材测试全部四家。
只有肖像时,选择图片转说话视频;要保留实拍表演,则选择已有视频对口型。
什么是说话照片?
说话照片从静态图生成动作。系统必须创造嘴型,通常还要生成下颌、眨眼、表情或头部动作。原图提供外观,不包含已记录的表演。
所以选输入很重要。清晰正面照片给模型可见五官;拥挤婚礼照里的小脸,或被头发遮住的侧脸,都更难。
它也不同于配旁白的幻灯片。幻灯片里肖像保持静止;说话照片则生成可见发音动作,因此会产生静态图没有的身份或运动错误。
与视频对口型有什么区别?
| 问题 | 说话照片 | 已有视频对口型 |
|---|---|---|
| 来源 | 一张静态图 | 录制或生成的视频 |
| 动作 | 必须从图片生成 | 从动态表演调整 |
| 典型目标 | 主播、祝福、短讲解 | 替换一句、采访配音、本地化 |
| 审核主要风险 | 虚构动作改变脸 | 调整破坏原始表演 |
已有老师实拍视频,用视频配音路径;有员工头像和获批准欢迎语,用说话照片路径。选错输入会增加不必要的编辑工作。
唱歌照片相关,但属于不同用途。长音和音乐需要独立样片。说话祝福可信,不代表副歌也能令人信服。
用五个实际问题选择
能用自己的音频吗?
上传录音可在图片工具之外批准时序和发音,适合已有配音演员或成品旁白的情况。不想用麦克风时,文字脚本更方便。
确认上传音频、内置语音和克隆是否在同一模式。输入不同,套餐要求也可能不同。列有预设声音,不证明能上传你的录音。
工具支持你的具体图片吗?
真人头像、类人插画、宠物脸和动漫角色是不同测试。查看明确模型支持并做小样,特殊素材的首次实验不要直接生成昂贵长片。
重要词语能读对吗?
测试品牌、人名、数字和术语。先听音频,再生成动作。TTS 若读错产品,脸可能很好地同步了错误发音。
能导出所需版本吗?
记录分辨率、比例、水印、长度、格式。如果下载受限或裁掉下巴,预览成功并不足够。竖屏社交帖子要按手机尺寸审核。
图片、声音与输出权限足够吗?
上传照片的权利,与模仿声音的权利不同。付费账户不能让你擅自表现不愿配合的人说新台词。发布前核查源素材和具体输出条款。
在线说话照片路径简表
| 路径 | 文档起点 | 应考察的声音路径 | 主要边界 |
|---|---|---|---|
| LipSyncX | 肖像加音频或文字 | 上传或生成语音 | 测试当前模型和设置 |
| D-ID Studio | 文字、音频、静态图 | Studio 声音或音频流程 | 区分 Studio 与 Video Translate |
| HeyGen 照片虚拟人 | 单图加音频或脚本 | 录音、TTS、获授权克隆 | 确认模式和套餐 |
| Sync sync-3 | 2026 年 6 月说明的单图生成 | 脚本、上传或克隆 | 不假定旧模型相同 |
本表刻意不把全公司的语言总数复制到每行。语音生成、翻译和口型动画覆盖可能不同。应确认要使用的具体声音和功能。
利益披露: LipSyncX 发布本文,并提供商用说话照片产品。比较针对文档输入路径和流程匹配,不提供独立真实感评分。
LipSyncX:从肖像和短信息开始
LipSyncX 说话照片工具 是放入头像和获批准声音的直接入口。投入整套课程或广告前,先试短信息。
优点: 清晰的肖像/音频起点和保留的第一方案例。缺点: 一张好肖像结果不能证明所有脸、风格、语言或长录音可靠。扩大制作前查看报价、审核导出。
D-ID:考察结构化虚拟人流程
D-ID Studio 页面 介绍以文字、音频和图像生成虚拟人视频。适合讲解主播与已使用其企业流程的团队考察。
优点: 照片创作是明确产品路径。缺点: 不应假定 Studio 和翻译功能是一项共同权益。套餐权利、品牌标记、所需导出分别核查。
HeyGen:考察更广的创作工作区
HeyGen 对口型页面 除实拍工具外,也有说话照片路径。小团队希望在同一工作区获得脚本、声音或本地化时,可考虑。
优点: 多个阶段能共享一个创作过程。缺点: 具体模型和套餐决定实际流程。广泛的功能页不证明每类输入表现相等。
Sync:区分 sync-3 和对旧模型的认识
Sync 单图指南 日期为 2026 年 6 月 21 日,介绍 sync-3 从静态图创建动作,也谈到能辨认为人的角色插画。
优点: 明确说明该模型支持单图。缺点: 把它套用到所有历史模型或任意非人角色会误导。提交前在账户确认确切模型。
更多选择见生成器候选指南。挑两条输入匹配的路径,而不是把照片工具和要求不同源素材的实拍流程直接比较。
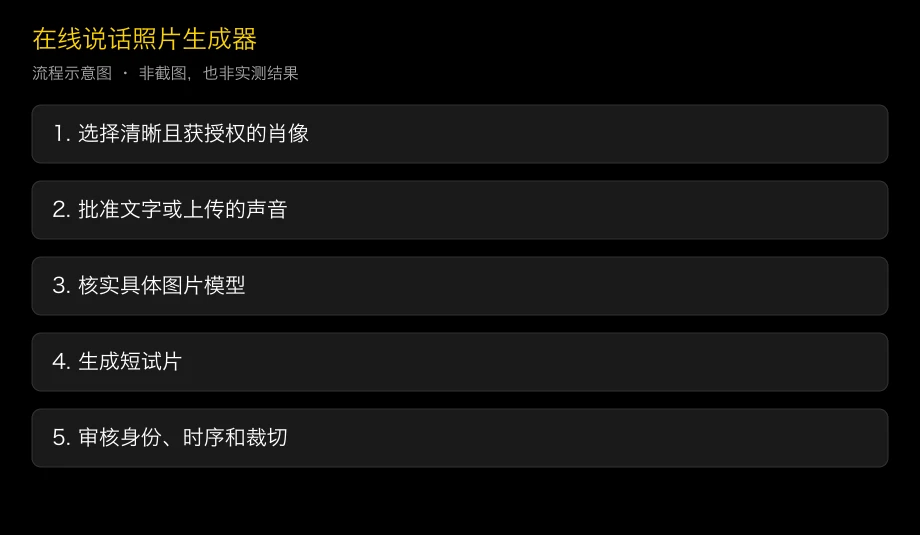
四步制作第一段
- 准备图片。 单脸清楚、下巴完整、保留足够肩部,并保存原件。有更好源图时,不用重度压缩截图。
- 准备声音。 写短信息或上传批准音频。生成脸前听名字、节奏和句尾。
- 生成试片。 检查模型、尺寸、时长报价、导出条款,和源文件一起保存设置。
- 审核导出。 正常速度播放,检查困难时间点和最终裁切。批准版本与被拒版本分开保管。
十秒试片是编辑建议,不是通用上传上限。可容纳一句、停顿和结尾,同时避免每次初期修正都很贵。重视发音时,用真实内容,不用通用演示句。
没有录音,可看文字转语音照片指南。它将批准声音与生成动作分开,避免脚本变动带来不必要重做。
只有头像能做什么?
入职欢迎要使用同意信息与用途的人。第一段可写:“欢迎加入团队。打开清单,再选择第一个任务。”结尾要和开头一样认真审查。
产品讲解中,肖像片段简短,切到真实产品。人物无需占满全片。近景演示或屏幕录像通常更能讲清细节。
祝福用原创短句和获授权图片。若惊喜上传收件人照片,应考虑对方是否合理预期这种用途。许可是生产输入,不应留到渲染后解决。
历史肖像或插画能用吗?
历史照片的版权,与所示人物肖像或相关声音的权利可能不同。先确认图片权利,不把生成语音当成找回的录音。观众可能误认真实时,清楚标明戏剧性重现。
插画不一定符合真人五官几何。小嘴、特殊眼睛或扁平侧脸可能产生虚构牙齿、动作不稳。选明确说明该输入的模型,并按风格化动画审核。
宠物脸又是不同几何。支持类人角色不代表支持狗的口鼻。短试做必不可少,趣味结果不能当作真实人类说话表现的证据。
为什么说话照片会不自然?
常见问题包括下巴裁切、嘴部遮挡、表情过度和语速太快。首次保持简单:单脸、清楚对白、克制表演、清晰图片。
脸部身份改变就拒绝导出,换更好源图或路径。声音匆忙就改句子。停顿仍动嘴,则记录时间点,检查时序设置或模型。
审核整脸和脖子,不只嘴唇。牙齿闪烁、胡须改变、眼镜不稳,即使音节对齐也会干扰。静态截图无法证明运动可接受。
把源素材和决策一起保存
归档图片、批准音频、文字、模型、日期、报价、设置、最终导出。这个小证据包帮助复现成功或诊断后续失败,也避免新脚本误配旧音轨。
多语言项目要逐语加入母语审核批准。语言选择框不能确认发音。将翻译批准与视觉批准分开,才能知道该修哪个阶段。
常见问题
做说话照片需要原始视频吗?
不需要。真正的说话照片流程从静态图生成动作。已有视频对口型则从视频开始,是不同路径。
能用我自己的声音吗?
支持上传录音时通常可以。确认具体功能,并使用你获准上传和发布的声音。
在线代表没有上传吗?
不是。浏览器流程通常发送文件到服务处理。上传敏感人脸或录音前看隐私和留存条款。
一张照片能做整堂课吗?
视产品和时长限制可能可以,但先测短片。长课混合主播与实用演示,并审核片段间连贯性。
说话照片等同声音克隆吗?
不是。照片流程生成可见动作;声音克隆创建或模仿声音,需要自己的许可和功能支持。
从最短且有用的信息开始
带一张获授权头像和两句脚本打开说话照片工具。批准声音、做短试片,并按计划发布的准确裁切检查。
更新记录
- 2026-10-25: 核查 D-ID、HeyGen、Sync 官方图片路径。增加模型边界、四步试做,以及历史图片、插画、声音和导出的独立检查。