
Чи можна синхронізувати фото з аудіо онлайн?
Так. Можна синхронізувати фото з аудіо онлайн, якщо сервіс приймає нерухоме зображення та ваш аудіофайл. Завантажте обидва файли, створіть рухи обличчя й перегляньте відео, що говорить, у браузері. Інструмент, який лише змінює голос у готовому матеріалі, може вимагати саме відео.
Перевірено: 25 жовтня 2026 року. Ми переглянули офіційну документацію та повторно використали власний приклад LipSyncX, створений 22 жовтня. Він демонструє один мальований портрет і одну промовлену фразу, але не визначає переможця серед усіх інструментів.
Розкриття інтересу: LipSyncX публікує цей посібник і продає відповідний сервіс генерації. Наведені рекомендації розрізняють документовані можливості та спостережувані результати.
Що насправді створює синхронізація губ на фото?
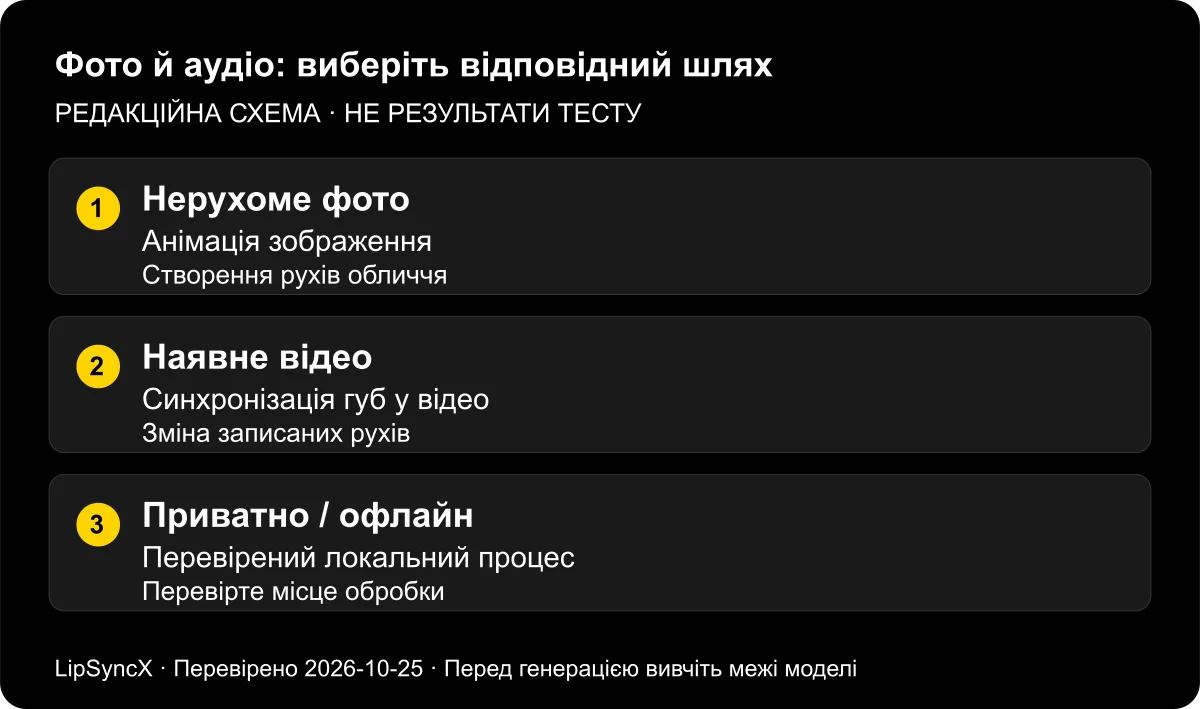
На фотографії немає записаних рухів рота. Модель анімації має створити проміжні кадри: відкривання щелепи, змикання губ, а часто й рухи очей або голови. Аудіо задає час, а зображення — початковий вигляд.
Синхронізація наявного відео має іншу відправну точку. Вона змінює рухи обличчя у зйомці, де вже є виконання, ракурс камери та тло. Заміна англійського голосу іспанським записом у знятому інтерв'ю — завдання для відео. Перша фраза нерухомого портрета — завдання для зображення.
Ця різниця пояснює поширену невдачу ще до генерації: сайт називає себе сервісом синхронізації губ, але його завантажувач просить MP4 замість JPG. Перевірте допустимі матеріали до створення облікового запису чи придбання кредитів.
Браузерний процес може анімувати одне фото під завантажене аудіо, але підтримку зображень потрібно перевірити для конкретного інструмента та моделі. Самої підтримки відеодубляжу недостатньо.
Схема пояснює два шляхи. Це редакційна ілюстрація, а не знімок екрана чи виміряний результат.
Який онлайн-процес підходить вашим матеріалам?
Наведена таблиця описує завдання, а не загальний рейтинг. Офіційні сторінки перевірено 25 жовтня 2026 року; доступні моделі та можливості облікового запису можуть змінитися.
| Початковий матеріал | Який процес шукати | Що перевірити до оплати |
|---|---|---|
| Один портрет і готовий запис | Перетворення зображення на відео, що говорить | Завантаження нерухомого зображення, аудіо та доступність моделі |
| Один портрет і текст | Фотоаватар із синтезом мовлення | Прослуховування голосу, вимова та права на створене аудіо |
| Інтерв'ю та новий закадровий голос | Синхронізація наявного відео | Приймання відео, робота зі спікерами, керування часом |
| Мальований талісман | Анімація зображення з підтримкою персонажів | Приклади конкретної моделі та якість короткого тесту |
| Конфіденційні матеріали, які не можна передавати з пристрою | Перевірений локальний процес | Обробка офлайн, залежності, ліцензія та обладнання |
Сторінка інструмента HeyGen описує роботу і з фото, і зі зйомкою. Посібник Sync зі створення відео із зображення описує генерацію з нерухомого зображення через sync-3. Це заяви постачальників про можливості, а не незалежні вимірювання якості.
У LipSyncX для зображення почніть із генератора фото, що говорять. Якщо вже є зйомка й потрібно зберегти початкове виконання, використовуйте сторінку відеодубляжу.
Чотири кроки для першої спроби
1. Підготуйте одне обличчя, яке дозволено використовувати
Виберіть чіткий портрет анфас із видимим ротом. Рука, мікрофон, маска чи глибока тінь на губах створюють додаткову неоднозначність. Якщо інструмент не має явного вибору людини, обріжте багатолюдне групове фото до потрібної особи.
Використовуйте свій портрет, ліцензовану ілюстрацію або зображення, власник і зображена людина якого дозволили таке використання. Загальнодоступність фото не означає дозволу його анімувати. Для робочого ведучого отримайте відповідне погодження до завантаження обличчя працівника.
2. Підготуйте короткий розбірливий запис
Почніть із 5–10 секунд мовлення однієї людини. Це запропонована нами довжина пробного фрагмента, а не ліміт платформи. Залиште початок і кінець речення; прослухайте запис на перевантаження, кімнатне відлуння та довгі порожні ділянки.
Використовуйте експортований файл замість потокового посилання, якщо завантажувач прямо не підтримує таке посилання. Збережіть оригінальний запис без змін, щоб порівняти іншу модель на точно такому самому матеріалі.
3. Завантажте, перевірте й запустіть генерацію
Завантажте зображення та виберіть завантаження Audio, якщо хочете зберегти наявний запис. Поле Text зазвичай створює іншу звукову доріжку й не замінює завантаження вашого виконання.
Перевірте назву файла, відтворення, вибрану модель, розмір результату та показану вартість. Замініть будь-яке типове демонстраційне аудіо. Якщо попередній перегляд досі відтворює демонстраційний голос, потрібний запис ще не підтверджено.
4. Перегляньте збережене відео
Спочатку відтворіть ролик зі звуком на звичайній швидкості, а вже потім перевіряйте окремі кадри. Зверніть увагу на початки речень, змикання губ, паузи й останнє слово. Завантажте файл і відтворіть його окремо: сам перегляд у застосунку не підтверджує придатності кінцевого файла.
Пояснення елементів введення й перелік перевірок експорту наведено в посібнику з фото та власного аудіозапису.
Що доводить наш збережений приклад?
Нашого власного вигаданого лиса Kit анімували 22 жовтня 2026 року в LipSyncX 2 Fast із налаштуванням 480p. Запис генерації фіксує відео 3.682993 секунди, 480 × 480, зі звуковою доріжкою. Ілюстрацію та синтетичне привітання створено для LipSyncX, а не взято з матеріалів клієнтів.
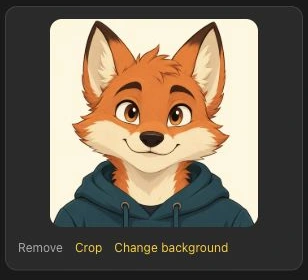
Перегляньте оригінальне привітання Kit і порівняйте з початковим аудіо. Це придатний для повторного використання приклад однієї завершеної генерації. Через коротшу тривалість він не замінює нового порівняльного тесту на 5–10 секунд.
Інший історичний тест відповідає запропонованій десятисекундній довжині. 12 жовтня LipSyncX 2.0 Pro та Lip-Sync.ai Singing 1.0 створили ролики з одного портрета Мони Лізи та ідентичного вокального WAV. 25 жовтня ми повторно перевірили технічні параметри обох збережених результатів: кожен триває 10.000 секунд за 25 кадрів/с. Фактичні розміри різні: 784 × 1152 і 512 × 752. Тому не слід вважати їх рівнозначними рівнями моделей.
Перегляньте десятисекундний результат LipSyncX, результат Lip-Sync.ai та прослухайте спільне аудіо. Фотографія портрета і запис позначені CC0. Ця ШІ-демонстрація не є справжнім виконанням чи рекомендацією з боку зображеної особи.

Ранні п'ятисекундні спроби лише з інструментальним вступом виключено з оцінювання співу. Виправлений вхід містить вокал і акомпанемент; час слів з автоматичної транскрипції не є ручною оцінкою синхронізації.
Приклад не доводить, що підійде кожне фото, що інструмент зберігає всі деталі зовнішності або має кращий таймінг за інший сервіс. Для цієї статті ми не проводили нового порівняльного тесту якості; історична пара доступна для перегляду без оголошення загального переможця. Для нового проєкту використовуйте дозволений портрет і той самий короткий запис у всіх кандидатах, зберігаючи кожен експорт та його налаштування.
Коли результат не вдасться або розчарує?
У малого обличчя замало видимих деталей рота. Збільшення після генерації не відновить переконливого виконання, якого модель не створила. До витрат на експорт вищої роздільності виберіть зображення з придатними деталями обличчя.
Людина може добре чути аудіо, яке важко зіставити з одним ротом. Накладання спікерів, бек-вокал, щільну музику та шумні записи потрібно перевіряти окремо. Приймання аудіофайла моделлю не означає належних рухів обличчя протягом усієї доріжки.
Згенеровані рухи голови можуть створити іншу проблему: спочатку обличчя нагадує вхідне, але змінюється під час мовлення. Це проблема стабільності зовнішності, а не лише часу. Для представника бренду відхиляйте результат, що змінює характерні риси, навіть якщо слова здаються синхронними.
| Симптом | Що спробувати змінити спочатку |
|---|---|
| Рот прихований або майже непомітний | Візьміть ближчий портрет без перекриттів |
| Рот рухається в тиші | Видаліть зайве аудіо й повторіть той самий інтервал |
| Здається, що говорять кілька людей | Виділіть одне обличчя або використайте документований вибір особи |
| Персонаж спотворюється | Спробуйте сумісну модель або простіший дизайн |
| Попередній перегляд працює, завантажений файл — ні | Перевірте право експорту й відтворіть збережений файл |
Перед повторною купівлею генерацій із незмінними входами прочитайте посібник з усунення проблем синхронізації.
Чи означає онлайн відсутність встановлення або передавання матеріалів?
Браузерна генерація зазвичай дає змогу обійтися без окремого редактора. Але матеріали все одно передаються постачальнику, якщо сервіс прямо не описує локальну обробку. Відкриття сайту у приватному вікні браузера не робить серверну генерацію локальною.
Самостійно розміщена система теж може відкриватися в браузері, але комусь доведеться встановити й підтримувати серверну частину. Назва «онлайн» описує інтерфейс, а не оператора інфраструктури. Потребу в офлайн-обробці слід перевіряти окремо.
Перш ніж використовувати чутливе зображення обличчя чи голос, перевірте засоби видалення, зберігання, положення про навчання та погодження організації. Для одноразової перевірки можливості власний вигаданий малюнок і короткий власний запис зменшують обсяг особистих матеріалів.
Поширені запитання
Чи можна безкоштовно синхронізувати фото з аудіо онлайн?
Деякі сервіси пропонують пробний доступ. Перевірте поточні ліміти, водяний знак, можливість експорту та дозволене використання у своєму обліковому записі. Безкоштовний перегляд не підтверджує наявності відео для завантаження з комерційними правами.
Чи можна використовувати телефон замість комп'ютера?
Часто — через мобільний застосунок або сумісний браузер. Вибір файлів, доступ до моделей та експорт можуть відрізнятися. Перед перенесенням великого проєкту на телефон ознайомтеся з браузерним генератором фото, що говорять.
Чи можна використати запис співу?
Виберіть сервіс із документованою підтримкою співу та спочатку перевірте один чіткий вокальний уривок. Повна пісня з кількома співаками складніша за одне промовлене речення.
Чи відтворить відео справжню міміку людини?
Фотографія не записує, як людина виконала б цю фразу. Створені вирази — інтерпретація. Не видавайте результат за справжню зйомку людини, яка говорить ці слова.
Зробіть перший тест достатньо коротким для оцінки
Відкрийте генератор фото, що говорять, завантажте один дозволений портрет і одну коротку фразу. Зберігайте зображення, аудіо, результат і налаштування разом. Після перегляду ролика поверніться до основного посібника з AI lip sync, щоб ухвалити наступне рішення.
Журнал змін: 25 жовтня 2026 року — перевірено офіційну документацію браузерного доступу та приймання зображень; повторно використано приклад від 22 жовтня з його фактичною тривалістю; нового міжсервісного тесту не заявлено.