
能在线让照片跟随音频对口型吗?
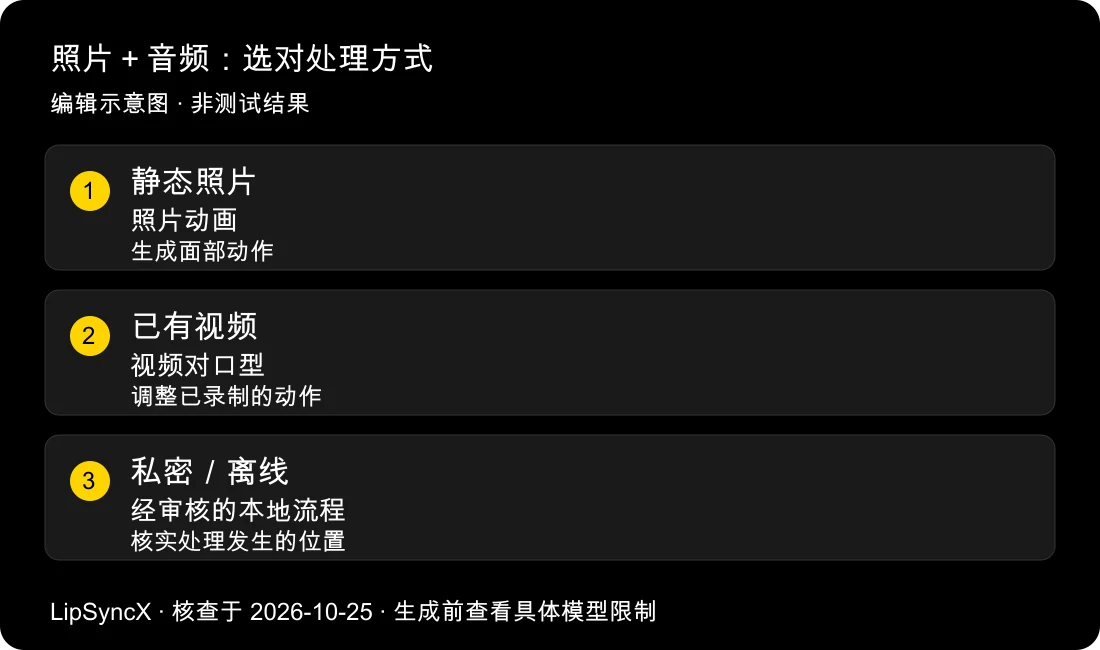
可以。只要服务接受一张静态照片和你的音频文件,就能在线让照片跟随音频对口型。上传两者后,系统生成面部动作,你可以在浏览器查看说话视频。若工具只能给已有画面换声,可能仍然要求视频输入。
核查日期:2026年10月25日。 我们查阅了官方产品文档,并复用了10月22日制作的 LipSyncX 原创样例。该样例只展示一张卡通肖像和一句对白,不能据此评出各工具的优胜者。
利益披露:本指南由 LipSyncX 发布,我们销售相关生成服务。下文会区分官方说明的能力与实际观察到的输出。
照片对口型究竟生成了什么?
照片没有记录嘴部运动。照片动画模型必须生成中间帧,包括张开下颌、闭合嘴唇,通常还会生成眼睛或头部动作。音频提供时间节奏,图片提供起始外观。
已有视频对口型的起点不同:它调整已经包含表演、拍摄角度和背景的画面中的面部动作。把访谈视频的英语旁白替换成西班牙语录音,属于视频处理;让肖像第一次开口,则属于图片处理。
这个区别能解释一种生成前就会遇到的问题:网站自称对口型服务,上传器却要求 MP4 而不是 JPG。在注册或购买积分前,先确认支持的输入格式。
浏览器流程可以让一张照片跟随上传的音频动起来,但必须核实所选工具和模型是否支持图片输入;仅支持视频配音还不够。
此图解释两种处理方式,是编辑绘制的示意图,不是界面截图,也不是实测输出。
哪种在线流程适合你的素材?
下表按任务分类,不是综合排名。官方页面核查于2026年10月25日;可用模型和账号权限可能变化。
| 起始素材 | 应寻找的流程 | 付款前核查 |
|---|---|---|
| 一张肖像和录好的音频 | 图片生成说话视频 | 静态图片上传、音频上传、模型是否可用 |
| 一张肖像和文字稿 | 带文字转语音的照片头像 | 声音预听、发音、生成音频的使用权 |
| 访谈视频和替换旁白 | 已有视频对口型 | 视频输入、说话人处理、时间控制 |
| 插画吉祥物 | 兼容角色的图片动画 | 具体模型样例和短片测试质量 |
| 不可离开设备的保密素材 | 经审核的本地流程 | 离线处理、依赖、许可、硬件 |
HeyGen 对口型工具页介绍了照片和已有视频两条流程。Sync 图片转视频指南介绍了通过 sync-3 生成静态图片动画。这些是厂商能力说明,不是独立质量测量。
在 LipSyncX 中,图片应从说话照片生成器开始;如果已有视频需要保留原始表演,则使用视频配音页面。
第一次尝试按四步进行
1. 准备一张获准使用的脸部图片
选择清晰、正面、嘴部可见的肖像。手、麦克风、口罩或覆盖嘴唇的浓重阴影都会增加判断难度。如果工具没有明确的主体选择功能,先把杂乱合照裁到目标人物。
使用自己的肖像、获得许可的插画,或图片权利人及被摄者都已同意此用途的照片。照片能在网上公开看到,不代表获准将其动画化。制作工作场景讲解员时,上传员工面孔前应取得相应批准。
2. 准备一段短而清晰的录音
先用单个说话人的5–10秒音频。这是我们建议的试片长度,不是平台限制。保留句子的开头和结尾,并检查削波失真、室内回声和过长的空白。
除非上传器明确支持流媒体链接,否则使用导出的音频文件。保持原始录音不变,便于用完全相同的素材比较其他模型。
3. 上传、检查,再生成
加载图片;如果要保留现有录音,选择上传音频。文字输入框通常会生成另一条音轨,不能代替上传你的原始表演录音。
检查文件名、播放内容、所选模型、输出尺寸及显示的费用。替换默认示例音频。如果预览仍播放演示声音,就还没有确认所需录音已成功选中。
4. 检查保存下来的视频
先带声音正常速度播放,再逐帧检查。留意句首、闭唇、停顿和最后一个词。随后下载文件并单独播放:应用内预览正常,不足以确认交付文件可用。
带标注的输入控件和导出清单,请继续查看照片配音教程。
现有样例能证明什么?
我们原创的虚构狐狸 Kit 于2026年10月22日使用 LipSyncX 2 Fast、480p 设置生成动画。生成记录显示,视频长 3.682993秒,尺寸480 × 480,含音轨。图片和合成欢迎旁白专为 LipSyncX 创作,并非来自客户素材。
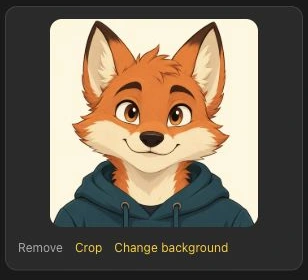
播放 Kit 原始欢迎短片,并与输入音频对照。这是一次已完成生成的可复用样例。由于时长较短,它不能满足新的5–10秒对比测试要求。
另一项历史测试符合建议的10秒试片长度。10月12日,LipSyncX 2.0 Pro 和 Lip-Sync.ai Singing 1.0 使用同一张蒙娜丽莎肖像和完全相同的人声 WAV 生成视频。我们在10月25日重新检测了两份已保存输出:两者均为10.000秒、25 fps。实际尺寸分别为784 × 1152和512 × 752,因此不能视为同级别模型。
播放10秒 LipSyncX 结果、播放 Lip-Sync.ai 结果,并收听两者共用的音频。肖像照片和录音均标为 CC0。这是 AI 演示,不是真实表演,也不代表背书。

较早的5秒纯器乐尝试已从唱歌评估中排除。修正后的输入包含人声和伴奏;自动转写时间点不是人工同步评分。
它不能证明每张照片都适用、工具能保留所有身份细节,或其同步优于另一服务。本文没有进行新的质量基准测试;历史双输出可供查看,但不宣布综合优胜者。新项目请在候选服务中使用获准肖像及完全相同的短录音,并保留每份导出和设置。
哪些情况下结果会失败或令人失望?
脸部太小,可见嘴部细节就少。生成后再放大,也无法重建从未生成的可信表演。在花钱导出更高分辨率前,先选面部细节足够的图片。
人能听清的音频,也可能难以对应到一张嘴。重叠说话、和声、密集音乐和嘈杂录音应单独测试。模型接受了音频文件,不代表全程都能生成合适的面部动作。
生成的头部动作还可能带来另一问题:开头像原图,说话时却变了脸。这属于身份稳定性问题,不只是时间同步。品牌代言形象即使看似对上了台词,只要显著特征改变,也应拒收。
| 症状 | 首先尝试的调整 |
|---|---|
| 嘴部被遮挡或几乎看不见 | 换成更近、无遮挡的肖像 |
| 静音时嘴仍在动 | 删除无关音频,对同一时间段重测 |
| 多个人都像在说话 | 单独保留一张脸,或选择明确支持主体选择的功能 |
| 角色变形 | 尝试兼容模型,或简化角色设计 |
| 预览正常但下载失败 | 检查导出权限,并播放保存文件 |
在素材不变的情况下反复付费生成前,请先看对口型故障排查指南。
在线是否意味着不用安装,也不用上传?
浏览器生成通常不必安装专用编辑器,但除非服务明确说明在本地处理,仍需把素材上传给厂商。用无痕窗口打开网站,不会让服务器生成变成本地生成。
自托管系统也能通过浏览器访问,但仍有人需要安装和维护后端。“在线”描述的是界面,不代表基础设施由谁运营。需要离线处理的读者应另行核实这一要求。
使用敏感面孔或声音前,检查删除控制、留存、训练用途条文和组织批准情况。进行一次性的可行性测试时,使用原创虚构画作和自己的短录音,可以减少涉及的个人素材。
常见问题
能免费在线让照片跟随音频对口型吗?
部分服务提供试用。请在账号中查看当前额度、水印、导出权限和允许用途。免费预览不代表包含可下载且可商用的视频。
可以用手机代替电脑吗?
通常可以,通过移动应用或兼容浏览器操作。文件选择、模型权限和导出可能不同。把大型项目迁到手机前,先了解浏览器说话照片工作区。
可以使用唱歌录音吗?
选择明确说明支持唱歌的服务,并先测试一段清晰人声。包含多名歌手的整首歌曲,比一句对白更难处理。
视频会还原本人真实的表情吗?
照片没有记录那个人会如何演绎这句话。生成表情是一种推演,不能把结果当作对方真实说过这些话的视频。
让第一次测试小到足以判断
打开说话照片生成器,加载一张获准使用的肖像,上传一句短录音。把图片、音频、输出和设置放在一起保存。看完短片后,回到AI 对口型指南中心,比较下一步的选择。
更新日志:2026年10月25日——核查官方浏览器和图片输入文档;按真实时长复用10月22日样例;未声称进行新的跨工具基准测试。