
Posso sincronizzare le labbra di una foto con un audio online?
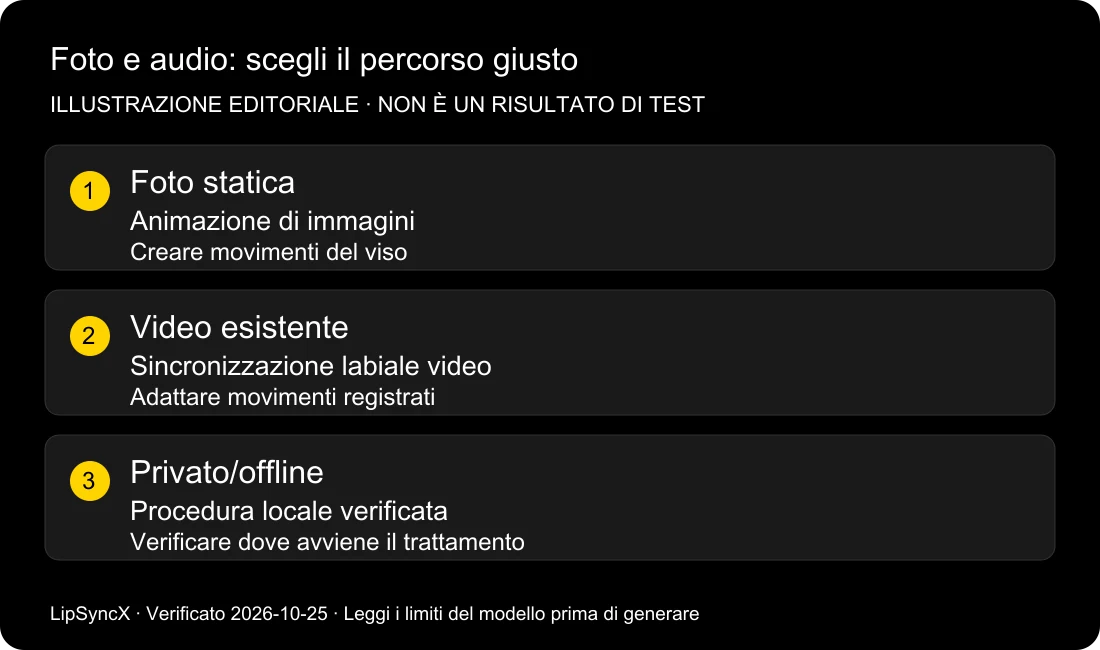
Sì. Puoi sincronizzare le labbra di una foto con un audio online se il servizio accetta un’immagine statica e il tuo file audio. Carichi entrambi, generi i movimenti del viso e controlli il video parlante nel browser. Uno strumento che cambia solo la voce di riprese esistenti potrebbe richiedere un video.
Verificato il 25 ottobre 2026. Abbiamo consultato la documentazione ufficiale e riutilizzato un esempio originale LipSyncX creato il 22 ottobre. Mostra un ritratto animato e una battuta; non stabilisce un vincitore tra strumenti.
Trasparenza: LipSyncX pubblica questa guida e vende un servizio di generazione correlato. Le raccomandazioni distinguono le funzionalità documentate dagli output osservati.
Che cosa crea davvero la sincronizzazione labiale di una foto?
Una fotografia non contiene movimenti della bocca registrati. Il modello deve inventare i fotogrammi intermedi: aprire la mandibola, chiudere le labbra e spesso muovere occhi o testa. L’audio fornisce i tempi, l’immagine l’aspetto iniziale.
La sincronizzazione di un video esistente parte da altro. Modifica movimenti facciali in riprese che possiedono già recitazione, angolazione e sfondo. Sostituire la voce inglese di un’intervista filmata con una registrazione spagnola è un lavoro sul video. Fare pronunciare la prima frase a un ritratto è un lavoro sull’immagine.
Questa differenza spiega un errore frequente prima ancora della generazione: un sito si definisce servizio di sincronizzazione labiale, ma chiede MP4 anziché JPG. Controlla gli input accettati prima di registrarti o comprare crediti.
Una procedura nel browser può animare una foto con audio caricato, ma va verificato il supporto alle immagini dello strumento e del modello scelti; il solo doppiaggio video non basta.
Il diagramma spiega i due percorsi. È un’illustrazione editoriale, non uno screenshot né un risultato misurato.
Quale percorso online è adatto al tuo materiale?
La mappa seguente descrive lavori, non una classifica generale. Le pagine ufficiali sono state verificate il 25 ottobre 2026; modelli e accessi degli account possono cambiare.
| Materiale iniziale | Percorso da cercare | Controlla prima di pagare |
|---|---|---|
| Un ritratto e una registrazione pronta | Immagine in video parlante | Caricamento immagine statica e audio, modello disponibile |
| Un ritratto e un testo | Avatar fotografico con sintesi vocale | Anteprima vocale, pronuncia, diritti sull’audio generato |
| Intervista e narrazione sostitutiva | Sincronizzazione di video esistente | Input video, gestione dei parlanti, controlli temporali |
| Mascotte illustrata | Animazione compatibile con personaggi | Esempi del modello e qualità di una prova breve |
| Media riservati che non possono lasciare il dispositivo | Procedura locale valutata | Elaborazione offline, dipendenze, licenza, hardware |
La pagina lip-sync di HeyGen documenta percorsi per foto e filmati. La guida immagini-video di Sync descrive la generazione da immagine statica con sync-3. Sono dichiarazioni del fornitore sulle capacità, non misurazioni indipendenti della qualità.
In LipSyncX, il generatore di foto parlanti è il punto di partenza per un’immagine. Usa la pagina di doppiaggio video se hai già riprese che devono conservare l’interpretazione originale.
Segui quattro passaggi al primo tentativo
1. Prepara un volto il cui uso sia autorizzato
Scegli un ritratto nitido, frontale e con la bocca visibile. Una mano, un microfono, una mascherina o un’ombra forte sulle labbra aumentano l’ambiguità. Ritaglia una foto di gruppo sul soggetto desiderato se manca una selezione esplicita della persona.
Usa il tuo ritratto, un’illustrazione con licenza oppure un’immagine il cui titolare e soggetto abbiano autorizzato questo uso. Una foto pubblica non dà automaticamente il permesso di animarla. Per un presentatore aziendale, ottieni le approvazioni necessarie prima di caricare il volto di un dipendente.
2. Prepara una registrazione breve e udibile
Inizia con 5–10 secondi di una sola persona. È la nostra durata pilota suggerita, non un limite della piattaforma. Includi inizio e fine della frase e ascolta eventuali distorsioni, eco e lunghi tratti vuoti.
Usa un file esportato anziché un collegamento streaming, salvo supporto esplicito del link. Conserva invariata la registrazione originale per confrontare un altro modello con lo stesso identico materiale.
3. Carica, controlla e poi genera
Carica l’immagine e scegli l’upload audio se vuoi preservare la registrazione. Un campo Testo crea generalmente una traccia diversa; non sostituisce il caricamento della tua interpretazione.
Controlla nome del file, riproduzione, modello, dimensioni di output e costo mostrato. Sostituisci l’audio dimostrativo predefinito. Se l’anteprima riproduce ancora la voce demo, la registrazione desiderata non è confermata.
4. Esamina il video salvato
Riproduci con audio a velocità normale prima di guardare i singoli fotogrammi. Controlla inizi delle frasi, chiusure delle labbra, pause e ultima parola. Poi scarica il file e riproducilo separatamente: la sola anteprima interna non conferma un file utilizzabile per la consegna.
Per controlli annotati e una lista di esportazione, prosegui nel tutorial foto e audio.
Che cosa dimostra il nostro esempio esistente?
La nostra volpe immaginaria originale, Kit, è stata animata il 22 ottobre 2026 con LipSyncX 2 Fast a 480p. Il registro indica un video di 3.682993 secondi, 480 × 480, con traccia audio. Disegno e benvenuto sintetico sono stati creati per LipSyncX, non ricavati da materiale dei clienti.
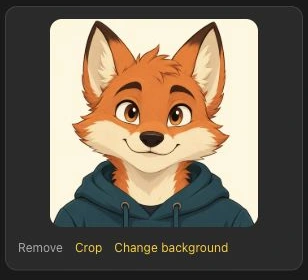
Riproduci il benvenuto originale di Kit e confrontalo con l’audio di input. È un esempio riutilizzabile di una generazione completata. Essendo più breve, non soddisfa un nuovo test comparativo di 5–10 secondi.
Un secondo test storico raggiunge i dieci secondi suggeriti. Il 12 ottobre, LipSyncX 2.0 Pro e Lip-Sync.ai Singing 1.0 hanno generato dallo stesso ritratto della Gioconda e da un WAV vocale identico. Il 25 ottobre abbiamo riesaminato i file: entrambi durano 10.000 secondi a 25 fps. Le dimensioni reali differiscono, 784 × 1152 e 512 × 752, quindi non sono livelli di modello equivalenti.
Riproduci il risultato LipSyncX di dieci secondi, quello di Lip-Sync.ai e ascolta l’audio comune. La fotografia del ritratto e la registrazione riportano CC0. Questa dimostrazione IA non è un’interpretazione autentica né un’approvazione.

I precedenti tentativi di cinque secondi solo strumentali sono stati esclusi dalla valutazione del canto. L’input corretto contiene voce e accompagnamento; i tempi della trascrizione automatica non sono un punteggio manuale di sincronizzazione.
Non dimostra che qualsiasi foto funzioni, che ogni dettaglio d’identità sia preservato o che i tempi superino quelli di altri servizi. Non abbiamo eseguito un nuovo benchmark qualitativo per questo articolo; i risultati storici sono consultabili senza un vincitore generale. Per un nuovo progetto, usa un ritratto autorizzato e la stessa registrazione breve sui candidati, conservando ogni esportazione e impostazione.
Quando il risultato può fallire o deludere?
Un volto piccolo offre pochi dettagli visibili della bocca. Ingrandirlo dopo non ricostruisce un’interpretazione convincente mai prodotta. Scegli un’immagine con dettagli facciali utili prima di pagare un’esportazione a risoluzione maggiore.
Un audio udibile da una persona può essere difficile da associare a una sola bocca. Voci sovrapposte, cori, musica densa e registrazioni rumorose vanno testati separatamente. Accettare un file non significa produrre movimenti appropriati per tutta la durata.
Il movimento della testa generato può creare un altro problema: all’inizio il volto assomiglia all’immagine, ma cambia parlando. È stabilità d’identità, non solo tempismo. Per un portavoce di marca, scarta output con tratti distintivi alterati anche se le parole sembrano sincronizzate.
| Sintomo | Prima modifica da provare |
|---|---|
| Bocca nascosta o quasi invisibile | Usa un ritratto più vicino e senza ostacoli |
| Bocca in movimento durante il silenzio | Rimuovi audio irrilevante e riprova lo stesso intervallo |
| Più persone sembrano parlare | Isola un volto o usa selezione documentata del soggetto |
| Personaggio deformato | Prova un modello compatibile o un disegno più semplice |
| Anteprima corretta ma download fallito | Controlla i diritti di esportazione e riproduci il file salvato |
Consulta la guida ai problemi di lip-sync prima di comprare generazioni ripetute senza cambiare gli input.
Online significa senza installazione o senza caricamento?
La generazione nel browser evita solitamente un editor dedicato. Richiede comunque di inviare i media al fornitore, salvo elaborazione locale esplicitamente documentata. La navigazione privata non rende locale una generazione su server.
Anche un sistema autogestito può essere accessibile via browser, ma qualcuno deve installare e mantenere il backend. Online descrive l’interfaccia, non chi gestisce l’infrastruttura. Se serve elaborazione offline, occorre verificare separatamente quel requisito.
Prima di usare un volto o una voce sensibile, controlla cancellazione, conservazione, clausole di addestramento e approvazione aziendale. Per una prova di fattibilità usa e getta, un disegno immaginario originale e una breve registrazione tua riducono i dati personali coinvolti.
FAQ
Posso sincronizzare una foto con audio online gratis?
Alcuni servizi offrono una prova. Verifica nel tuo account disponibilità attuale, filigrana, esportazione e usi consentiti. Un’anteprima gratuita non garantisce un video commerciale scaricabile.
Posso usare il telefono invece del computer?
Spesso sì, tramite app o browser compatibile. Selezione dei file, modelli ed esportazione possono variare. Consulta lo spazio per foto parlanti nel browser prima di spostare un progetto grande sul telefono.
Posso usare una registrazione cantata?
Scegli un servizio che documenti il canto e prova prima un passaggio vocale chiaro. Un’intera canzone con più cantanti è più difficile di una frase parlata.
Il video ricrea le vere espressioni della persona?
Una foto non registra come quella persona interpreterebbe la frase. Le espressioni generate sono un’interpretazione. Non presentare il risultato come filmato autentico della persona che pronuncia quelle parole.
Mantieni il primo test abbastanza piccolo da valutarlo
Apri il generatore di foto parlanti, carica un ritratto autorizzato e una breve frase. Conserva insieme immagine, audio, risultato e impostazioni. Dopo la verifica, torna al centro guide sulla sincronizzazione labiale IA per confrontare la decisione successiva.
Cronologia: 25 ottobre 2026 — verificata la documentazione ufficiale su browser e immagini; riutilizzato l’esempio del 22 ottobre con durata reale; non si dichiara un nuovo benchmark tra strumenti.