
Peut-on synchroniser les lèvres d’une photo avec un audio en ligne ?
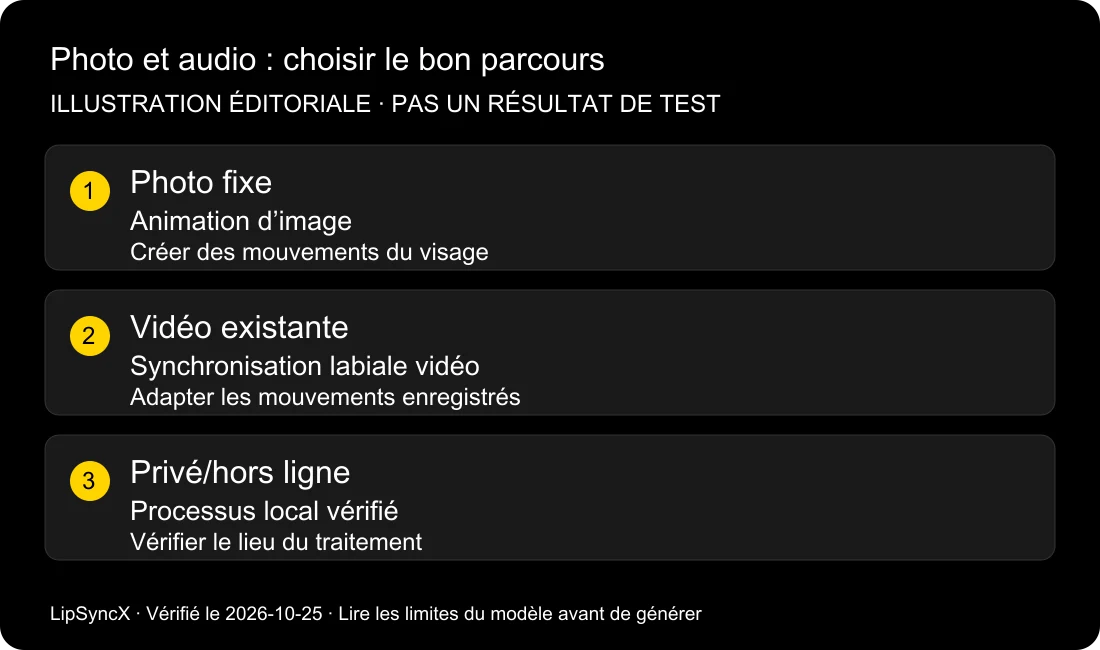
Oui. Vous pouvez synchroniser les lèvres d’une photo avec un audio en ligne si le service accepte une image fixe et votre fichier audio. Importez les deux, générez les mouvements du visage, puis examinez la vidéo parlante dans le navigateur. Un outil qui remplace seulement la voix d’une séquence existante peut exiger une vidéo.
Vérifié le 25 octobre 2026. Nous avons consulté la documentation officielle et réutilisé un exemple original LipSyncX créé le 22 octobre. Il montre un portrait de dessin animé et une phrase ; il ne désigne aucun gagnant entre les outils.
Transparence : LipSyncX publie ce guide et vend un service de génération connexe. Les recommandations distinguent les capacités documentées des résultats observés.
Que crée réellement la synchronisation labiale d’une photo ?
Une photographie ne contient aucun mouvement de bouche enregistré. Le modèle doit inventer les images intermédiaires : ouvrir la mâchoire, fermer les lèvres et souvent bouger les yeux ou la tête. L’audio fournit le rythme ; l’image fournit l’apparence initiale.
La synchronisation d’une vidéo existante part d’une autre base. Elle modifie le visage dans des images qui possèdent déjà une interprétation, un angle de caméra et un décor. Remplacer la voix anglaise d’un entretien filmé par un enregistrement espagnol est un travail sur vidéo. Faire prononcer sa première phrase à un portrait est un travail sur image.
Cette distinction explique un échec fréquent avant même la génération : un site se présente comme service de synchronisation labiale, mais demande un MP4 plutôt qu’un JPG. Vérifiez les entrées acceptées avant de vous inscrire ou d’acheter des crédits.
Un processus dans le navigateur peut animer une photo sur un audio importé, mais il faut vérifier l’entrée image pour l’outil et le modèle choisis ; la prise en charge du doublage vidéo ne suffit pas.
Ce schéma explique les deux parcours. C’est une illustration éditoriale, pas une capture d’écran ni un résultat mesuré.
Quel parcours en ligne correspond à vos sources ?
Le tableau décrit des tâches plutôt qu’un classement général. Les pages officielles ont été vérifiées le 25 octobre 2026 ; les modèles et l’accès des comptes peuvent changer.
| Matériel de départ | Parcours recherché | Vérifier avant de payer |
|---|---|---|
| Un portrait et un enregistrement terminé | Image vers vidéo parlante | Import d’image fixe, import audio, modèle disponible |
| Un portrait et un texte | Avatar photo avec synthèse vocale | Préécoute, prononciation, droits sur l’audio généré |
| Un entretien et une narration de remplacement | Synchronisation d’une vidéo existante | Entrée vidéo, gestion des intervenants, réglages temporels |
| Une mascotte illustrée | Animation compatible avec les personnages | Exemples propres au modèle et qualité d’un essai court |
| Des médias confidentiels qui ne peuvent quitter l’appareil | Processus local évalué | Traitement hors ligne, dépendances, licence, matériel |
La page de synchronisation de HeyGen décrit des parcours photo et vidéo. Le guide image-vers-vidéo de Sync décrit la génération depuis une image fixe avec sync-3. Ce sont des déclarations de fonctionnalités du fournisseur, pas des mesures indépendantes de qualité.
Dans LipSyncX, le générateur de photos parlantes est le bon départ pour une image. Utilisez la page de doublage vidéo si vous possédez une séquence dont il faut conserver l’interprétation originale.
Suivez quatre étapes pour le premier essai
1. Préparez un visage dont l’utilisation est autorisée
Choisissez un portrait net, de face, avec la bouche visible. Une main, un micro, un masque ou une ombre forte sur les lèvres ajoute de l’incertitude. Recadrez une photo de groupe sur la personne voulue si l’outil ne permet pas explicitement de choisir le sujet.
Utilisez votre portrait, une illustration sous licence ou une image dont le titulaire et la personne représentée ont autorisé cet usage. Une photo publique n’autorise pas automatiquement son animation. Pour un présentateur professionnel, obtenez l’accord nécessaire avant d’importer le visage d’un salarié.
2. Préparez un enregistrement court et audible
Commencez par 5–10 secondes avec une seule personne. Il s’agit de notre durée d’essai conseillée, pas d’une limite de plateforme. Incluez le début et la fin de la phrase, puis écoutez la saturation, l’écho et les longues plages vides.
Utilisez un fichier exporté plutôt qu’un lien de diffusion, sauf prise en charge explicite de ce lien. Conservez l’enregistrement original sans modification afin de comparer un autre modèle avec exactement la même source.
3. Importez, contrôlez, puis générez
Chargez l’image et choisissez l’import audio pour conserver l’enregistrement existant. Un champ Texte crée généralement une autre piste ; il ne remplace pas l’import de votre interprétation.
Vérifiez le nom du fichier, la lecture, le modèle, les dimensions et le coût affiché. Remplacez tout audio de démonstration par défaut. Si l’aperçu joue encore la voix de démonstration, l’enregistrement voulu n’est pas confirmé.
4. Examinez la vidéo enregistrée
Lisez avec le son à vitesse normale avant d’inspecter les images. Observez les débuts de phrase, les fermetures des lèvres, les pauses et le dernier mot. Téléchargez ensuite le fichier et lisez-le séparément : l’aperçu intégré ne confirme pas à lui seul un livrable utilisable.
Pour des commandes d’import annotées et une liste d’export, consultez le tutoriel photo et audio.
Que prouve notre exemple existant ?
Notre renard fictif original, Kit, a été animé le 22 octobre 2026 avec LipSyncX 2 Fast en 480p. Le reçu de génération indique une vidéo de 3.682993 secondes, 480 × 480, avec une piste audio. L’illustration et le message d’accueil synthétique ont été créés pour LipSyncX, pas tirés de médias clients.
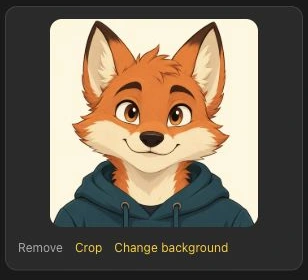
Lisez le message d’accueil original de Kit et comparez-le à l’audio d’entrée. C’est un exemple réutilisable d’une génération terminée. Sa durée plus courte signifie qu’il ne satisfait pas à un nouveau test comparatif de 5–10 secondes.
Un second test historique respecte la durée de dix secondes suggérée. Le 12 octobre, LipSyncX 2.0 Pro et Lip-Sync.ai Singing 1.0 ont utilisé le même portrait de Mona Lisa et un WAV vocal identique. Nous avons réanalysé les deux fichiers le 25 octobre : chacun dure 10.000 secondes à 25 fps. Leurs dimensions réelles diffèrent, 784 × 1152 et 512 × 752 : ils ne représentent donc pas des niveaux de modèle équivalents.
Lisez le résultat LipSyncX de dix secondes, celui de Lip-Sync.ai et écoutez leur audio commun. La photographie du portrait et l’enregistrement sont marqués CC0. Cette démonstration IA n’est ni une prestation authentique ni une approbation.

Les premiers essais de cinq secondes purement instrumentaux ont été exclus de l’évaluation du chant. L’entrée corrigée contient voix et accompagnement ; les repères de transcription automatique ne sont pas une note manuelle de synchronisation.
Cet exemple ne prouve ni que chaque photo fonctionne, ni que tous les détails d’identité sont préservés, ni que la synchronisation dépasse celle d’un concurrent. Nous n’avons pas réalisé de nouveau comparatif de qualité pour cet article ; les sorties historiques sont disponibles sans vainqueur global. Pour un nouveau projet, utilisez un portrait autorisé et le même court enregistrement chez les candidats, en conservant chaque export et ses réglages.
Quand le résultat risque-t-il d’échouer ou de décevoir ?
Un petit visage offre peu de détails de bouche. L’agrandir après génération ne reconstruit pas une prestation convaincante qui n’a jamais été produite. Choisissez une image suffisamment détaillée avant de payer un export haute résolution.
Un audio audible par une personne peut être difficile à attribuer à une seule bouche. Testez séparément les voix superposées, chœurs, musiques denses et enregistrements bruyants. Accepter le fichier ne garantit pas un mouvement approprié sur toute sa durée.
Les mouvements de tête générés peuvent créer un autre problème : le visage ressemble à l’entrée au début, puis change en parlant. C’est un défaut de stabilité d’identité, pas seulement de rythme. Pour un porte-parole de marque, refusez un résultat qui change les traits distinctifs même si les mots semblent synchronisés.
| Symptôme | Première modification à essayer |
|---|---|
| Bouche cachée ou à peine visible | Utiliser un portrait plus proche et dégagé |
| Bouche en mouvement pendant le silence | Retirer l’audio inutile et retester le même intervalle |
| Plusieurs personnes semblent parler | Isoler un visage ou utiliser une sélection documentée |
| Personnage déformé | Essayer un modèle compatible ou un dessin plus simple |
| Aperçu correct, téléchargement impossible | Vérifier le droit d’export et lire le fichier enregistré |
Consultez le guide de dépannage de synchronisation avant d’acheter des générations répétées sans modifier les entrées.
En ligne signifie-t-il sans installation ou sans transfert ?
Le navigateur évite généralement d’installer un éditeur dédié. Il faut néanmoins transférer les médias au fournisseur, sauf traitement local explicitement documenté. Ouvrir le site en navigation privée ne rend pas locale une génération sur serveur.
Un système autohébergé peut aussi être accessible par navigateur, mais quelqu’un doit installer et entretenir le serveur. En ligne décrit l’interface, pas l’opérateur de l’infrastructure. Si vous avez besoin d’un traitement hors ligne, étudiez cette exigence séparément.
Avant d’utiliser un visage ou une voix sensible, vérifiez suppression, conservation, clauses d’entraînement et autorisation de l’organisation. Pour un test de faisabilité jetable, une illustration fictive originale et votre propre court enregistrement réduisent les données personnelles impliquées.
Questions fréquentes
Peut-on synchroniser gratuitement une photo avec un audio en ligne ?
Certains services proposent un essai. Vérifiez dans votre compte l’allocation actuelle, le filigrane, l’export et les usages permis. Un aperçu gratuit ne garantit pas une vidéo commerciale téléchargeable.
Puis-je utiliser mon téléphone plutôt qu’un ordinateur ?
Souvent, via une application ou un navigateur compatible. Le choix des fichiers, l’accès aux modèles et l’export peuvent différer. Consultez l’espace photo parlante dans le navigateur avant de déplacer un grand projet sur mobile.
Puis-je utiliser un enregistrement chanté ?
Choisissez un service qui documente le chant et testez d’abord un passage vocal clair. Une chanson entière à plusieurs voix est plus difficile qu’une phrase parlée.
La vidéo recréera-t-elle les vraies expressions de la personne ?
Une photo n’enregistre pas la manière dont cette personne dirait la phrase. Les expressions générées sont une interprétation. Ne présentez pas le résultat comme une vidéo authentique de cette personne prononçant ces mots.
Limitez le premier essai pour pouvoir le juger
Ouvrez le générateur de photos parlantes, chargez un portrait autorisé et importez une courte phrase. Gardez ensemble image, audio, sortie et réglages. Revenez au centre de guides sur la synchronisation IA après visionnage pour comparer la prochaine décision.
Historique : 25 octobre 2026 — documentation officielle du navigateur et des images vérifiée ; exemple du 22 octobre réutilisé avec sa durée réelle ; aucun nouveau comparatif entre outils n’est revendiqué.