
Czy można zsynchronizować usta na zdjęciu z dźwiękiem online?
Tak. Możesz zsynchronizować usta na zdjęciu z dźwiękiem online, jeśli usługa przyjmuje obraz statyczny i Twój plik audio. Prześlij oba materiały, wygeneruj ruch twarzy i obejrzyj mówiący film w przeglądarce. Narzędzie zmieniające jedynie głos w istniejącym nagraniu może wymagać filmu.
Sprawdzono: 25 października 2026 r. Przejrzeliśmy oficjalną dokumentację i ponownie wykorzystaliśmy oryginalny przykład LipSyncX z 22 października. Pokazuje jeden rysunkowy portret i jedną wypowiedź; nie wskazuje zwycięzcy wśród narzędzi.
Ujawnienie powiązań: LipSyncX publikuje ten poradnik i sprzedaje powiązaną usługę generowania. Zalecenia odróżniają udokumentowane możliwości od zaobserwowanych wyników.
Co właściwie tworzy synchronizacja ust na zdjęciu?
Zdjęcie nie zawiera nagranego ruchu ust. Model musi wymyślić klatki pośrednie: otwieranie szczęki, zamykanie warg, a często ruch oczu lub głowy. Dźwięk dostarcza rytmu, a obraz początkowego wyglądu.
Synchronizacja istniejącego filmu zaczyna się inaczej. Zmienia ruchy twarzy w materiale, który ma już występ, kąt kamery i tło. Zamiana angielskiego głosu w nagranym wywiadzie na hiszpańskie nagranie to zadanie filmowe. Sprawienie, by portret wypowiedział pierwsze zdanie, to zadanie obrazowe.
Ta różnica wyjaśnia częsty problem jeszcze przed generowaniem: witryna nazywa się usługą synchronizacji ust, lecz wymaga MP4 zamiast JPG. Sprawdź obsługiwane wejścia, zanim założysz konto lub kupisz kredyty.
Proces w przeglądarce może animować zdjęcie do przesłanego dźwięku, ale trzeba sprawdzić obsługę obrazu w wybranym narzędziu i modelu; sam dubbing filmu nie wystarcza.
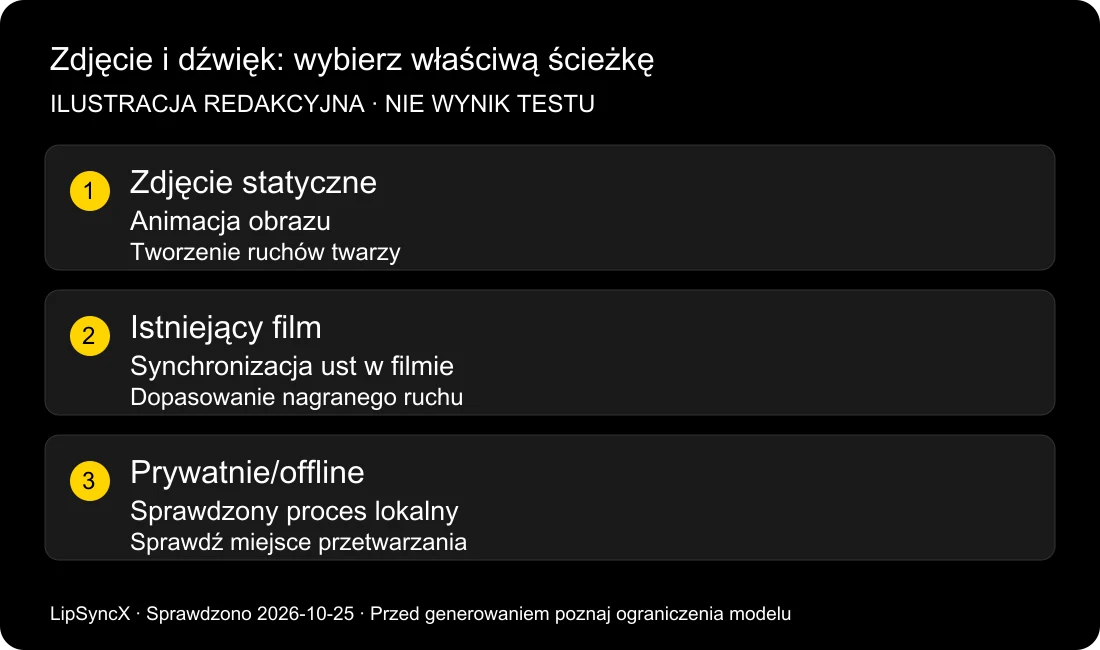
Schemat objaśnia obie ścieżki. To ilustracja redakcyjna, nie zrzut ekranu ani zmierzony wynik.
Która ścieżka online pasuje do Twoich materiałów?
Poniższa mapa opisuje zadania, a nie ranking ogólny. Oficjalne strony sprawdzono 25 października 2026 r.; modele i uprawnienia kont mogą się zmieniać.
| Materiał początkowy | Poszukiwana ścieżka | Sprawdź przed zapłatą |
|---|---|---|
| Portret i gotowe nagranie | Obraz w mówiący film | Przesyłanie zdjęcia i dźwięku, dostępność modelu |
| Portret i tekst | Awatar ze zdjęcia z syntezą mowy | Odsłuch głosu, wymowa, prawa do wygenerowanego audio |
| Wywiad i zastępcza narracja | Synchronizacja istniejącego filmu | Wejście wideo, obsługa mówców, kontrola czasu |
| Rysunkowa maskotka | Animacja obsługująca postacie | Przykłady danego modelu i jakość krótkiego testu |
| Poufne media, które nie mogą opuścić urządzenia | Zweryfikowany proces lokalny | Przetwarzanie offline, zależności, licencja, sprzęt |
Strona narzędzia HeyGen dokumentuje ścieżki zdjęciowe i filmowe. Poradnik Sync o obrazie i filmie opisuje generowanie z obrazu statycznego przez sync-3. To deklaracje funkcji dostawców, nie niezależne pomiary jakości.
W LipSyncX właściwym początkiem dla obrazu jest generator mówiących zdjęć. Użyj strony dubbingu filmów, jeśli masz już nagranie, które musi zachować oryginalny występ.
Przy pierwszej próbie wykonaj cztery kroki
1. Przygotuj jedną twarz z pozwoleniem na użycie
Wybierz wyraźny portret z przodu, z widocznymi ustami. Dłoń, mikrofon, maska lub mocny cień na wargach wprowadzają niejednoznaczność. Jeśli narzędzie nie ma jawnego wyboru osoby, wykadruj zatłoczone zdjęcie grupowe do właściwego bohatera.
Użyj własnego portretu, licencjonowanej ilustracji albo obrazu, którego właściciel i przedstawiona osoba zezwolili na taki użytek. Publiczna dostępność zdjęcia nie oznacza pozwolenia na animowanie. W przypadku prezentera firmowego uzyskaj odpowiednią zgodę przed przesłaniem twarzy pracownika.
2. Przygotuj krótkie, słyszalne nagranie
Zacznij od 5–10 sekund jednego mówcy. To proponowana długość próby, a nie limit platformy. Zachowaj początek i koniec zdania oraz posłuchaj, czy nie ma przesterowania, pogłosu i długich pustych fragmentów.
Użyj wyeksportowanego pliku zamiast odnośnika do streamingu, chyba że formularz wyraźnie go obsługuje. Zachowaj oryginalne nagranie bez zmian, by porównać inny model na identycznym materiale.
3. Prześlij, sprawdź, a potem generuj
Wczytaj obraz i wybierz przesyłanie audio, jeśli chcesz zachować istniejące nagranie. Pole Tekst zazwyczaj tworzy inną ścieżkę i nie zastępuje przesłania własnego występu.
Sprawdź nazwę pliku, odtwarzanie, wybrany model, rozmiar wyniku i wyświetlany koszt. Zamień domyślne próbki dźwiękowe. Jeśli podgląd nadal odtwarza głos demonstracyjny, właściwe nagranie nie zostało potwierdzone.
4. Sprawdź zapisany film
Odtwórz z dźwiękiem w normalnym tempie, zanim obejrzysz pojedyncze klatki. Sprawdź początki zdań, zamknięcia ust, pauzy i ostatnie słowo. Potem pobierz plik i odtwórz go osobno: sam podgląd w aplikacji nie potwierdza użytecznego pliku do przekazania.
Opisane kontrolki wejścia i listę eksportu znajdziesz w poradniku zdjęcia i audio.
Co dowodzi nasz istniejący przykład?
Nasz oryginalny fikcyjny lis Kit został animowany 22 października 2026 r. w LipSyncX 2 Fast przy 480p. Potwierdzenie generowania podaje film 3.682993 sekundy, 480 × 480, ze ścieżką audio. Ilustrację i syntetyczne powitanie stworzono dla LipSyncX, nie pobrano ich od klientów.
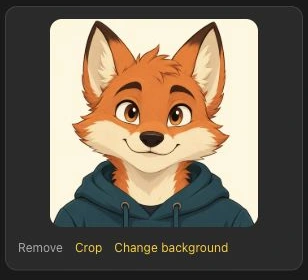
Odtwórz oryginalne powitanie Kita i porównaj z dźwiękiem wejściowym. To przykład ukończonego generowania do ponownego wykorzystania. Krótszy czas oznacza, że nie spełnia nowego testu porównawczego 5–10 sekund.
Drugi historyczny test spełnia sugerowane dziesięć sekund. 12 października LipSyncX 2.0 Pro i Lip-Sync.ai Singing 1.0 generowały z tego samego portretu Mony Lisy i identycznego wokalnego WAV. 25 października ponownie sprawdziliśmy zapisane pliki: oba mają 10.000 sekund i 25 fps. Rzeczywiste rozmiary różnią się: 784 × 1152 i 512 × 752, więc nie są to równoważne poziomy modeli.
Odtwórz dziesięciosekundowy wynik LipSyncX, wynik Lip-Sync.ai i posłuchaj wspólnego dźwięku. Zdjęcie portretu i nagranie oznaczono CC0. Ta demonstracja AI nie jest autentycznym występem ani rekomendacją.

Wcześniejsze próby pięciosekundowe z samym instrumentem wyłączono z oceny śpiewu. Poprawione wejście zawiera wokal i akompaniament; czasy automatycznej transkrypcji nie są ręcznie nadaną oceną synchronizacji.
Nie dowodzi to, że działa każde zdjęcie, że zachowane są wszystkie cechy tożsamości ani że synchronizacja przewyższa inną usługę. Nie przeprowadziliśmy nowego benchmarku jakości do tego artykułu; historyczne wyniki pary można obejrzeć bez ogólnego zwycięzcy. W nowym projekcie użyj dozwolonego portretu i identycznego krótkiego nagrania u kandydatów, zachowując każdy eksport i ustawienia.
Kiedy wynik zawiedzie lub rozczaruje?
Mała twarz daje niewiele szczegółów ust. Powiększenie po generowaniu nie odtworzy przekonującego występu, którego nie wygenerowano. Wybierz obraz z użytecznymi detalami twarzy przed zapłatą za wyższą rozdzielczość.
Dźwięk słyszalny dla człowieka może być trudny do przypisania jednym ustom. Nakładające się głosy, chórki, gęsta muzyka i hałaśliwe nagrania wymagają osobnych prób. Przyjęcie pliku nie oznacza odpowiednich ruchów przez cały czas.
Wygenerowany ruch głowy może stworzyć inny problem: twarz przypomina wejście na początku, lecz zmienia się podczas mowy. To stabilność tożsamości, nie tylko synchronizacja. Dla rzecznika marki odrzuć wynik zmieniający charakterystyczne cechy, nawet gdy słowa wyglądają na dopasowane.
| Objaw | Pierwsza próba poprawy |
|---|---|
| Usta zasłonięte lub ledwo widoczne | Użyj bliższego, niezasłoniętego portretu |
| Usta poruszają się w ciszy | Usuń zbędne audio i przetestuj ten sam odcinek |
| Kilka osób wygląda na mówiące | Wyizoluj jedną twarz lub użyj udokumentowanego wyboru osoby |
| Postać jest zniekształcona | Wypróbuj zgodny model lub prostszy projekt |
| Podgląd działa, pobieranie nie | Sprawdź uprawnienie eksportu i odtwórz zapisany plik |
Przeczytaj poradnik rozwiązywania problemów z synchronizacją, zanim kupisz kolejne generowania bez zmiany wejść.
Czy online oznacza bez instalacji albo bez przesyłania?
Generowanie w przeglądarce zwykle nie wymaga osobnego edytora. Nadal trzeba przesłać media dostawcy, chyba że wyraźnie dokumentuje lokalne przetwarzanie. Tryb prywatny nie zmienia generowania na serwerze w lokalne.
System hostowany samodzielnie także może działać przez przeglądarkę, ale ktoś musi zainstalować i utrzymywać backend. Online opisuje interfejs, nie operatora infrastruktury. Jeśli potrzebujesz offline, sprawdź ten wymóg osobno.
Przed użyciem wrażliwej twarzy lub głosu sprawdź usuwanie, retencję, zapisy o treningu i zgodę organizacji. Do jednorazowej próby wykonalności oryginalna fikcyjna ilustracja i własne krótkie nagranie ograniczają ilość danych osobowych.
Najczęstsze pytania
Czy można bezpłatnie zsynchronizować zdjęcie z audio online?
Niektóre usługi oferują próbę. Sprawdź na koncie aktualny limit, znak wodny, eksport i dozwolone zastosowania. Bezpłatny podgląd nie oznacza komercyjnego filmu do pobrania.
Czy mogę użyć telefonu zamiast komputera?
Często tak, przez aplikację lub zgodną przeglądarkę. Wybór plików, dostęp do modeli i eksport mogą się różnić. Sprawdź obszar mówiących zdjęć w przeglądarce, zanim przeniesiesz duży projekt na telefon.
Czy mogę użyć nagrania śpiewu?
Wybierz usługę z udokumentowaną obsługą śpiewu i najpierw sprawdź wyraźny fragment wokalu. Cała piosenka z wieloma wokalistami jest trudniejsza niż jedno zdanie.
Czy film odtworzy prawdziwą mimikę osoby?
Zdjęcie nie pokazuje, jak ta osoba wypowiedziałaby zdanie. Wygenerowane miny są interpretacją. Nie przedstawiaj wyniku jako autentycznego nagrania osoby mówiącej te słowa.
Pierwsza próba powinna być łatwa do oceny
Otwórz generator mówiących zdjęć, wczytaj dozwolony portret i prześlij krótką wypowiedź. Zapisz obraz, dźwięk, wynik i ustawienia razem. Po obejrzeniu wróć do centrum poradników synchronizacji AI, by porównać następną decyzję.
Historia zmian: 25 października 2026 r. — sprawdzono oficjalne dokumenty przeglądarki i obrazów; przykład z 22 października wykorzystano z rzeczywistą długością; nie deklarujemy nowego benchmarku między narzędziami.