
文字转语音,让照片开口说话:无需麦克风
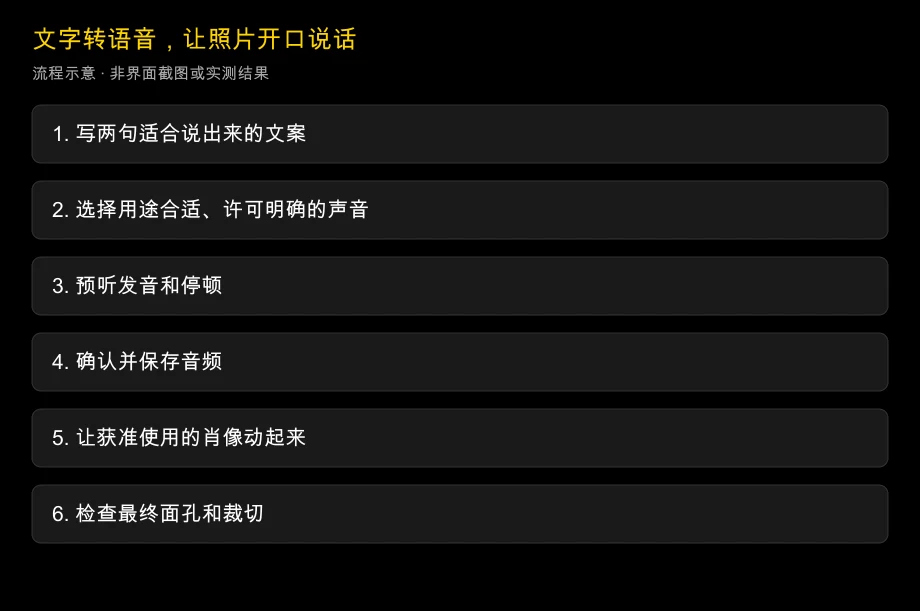
可以,不用自己录音,也能通过文字转语音让照片说话。先写文案,生成并确认获准使用的声音,再把音频交给图片生成说话视频的工具。有些平台整合了这三个阶段,但先确认声音再生成面孔,可以避免不必要的重新渲染。
核查日期:2026-10-25。 本指南查阅了 D-ID、HeyGen、Sync 和 ElevenLabs 官方说明。语言支持和停顿控制取决于具体语音模型,不能从厂商宣传的总体数字推断。
可靠顺序是文案、声音、面孔。嘴形即使同步正确,仍可能读错词,因此应先确认音频,再判断动画。
开始前需要什么?
准备一张获准使用的肖像、一份短文案,以及允许用于目标用途的声音。清晰正面、嘴部无遮挡的脸适合第一次测试。保留完整下巴,并为最终裁切留足周边空间。
普通文字转语音不需要麦克风。声音克隆是可选项,会增加同意要求。不需要模仿特定人物时,可以使用现成或设计的声音。
把源图、文字、最终音频和设置一起保存。之后修改文案时,另存新音频版本,不要覆盖旧版。这样更容易避免新字幕搭配旧录音。
分三个阶段让照片说话
1. 为听众写文案,而不是为阅读写
每句表达一个意思,把主要动作放在前面。即使最终由合成声音朗读,也先大声读一遍。如果你需要停下来理解自己的措辞,听众大概也一样。
首次文案以两句短句为宜。例如:“欢迎来到工作区。打开检查清单,然后选择第一项任务。”这是原创脚本示例,不是产品输出录音。
如果声音读错数字或缩写,就改为完整写法。写完长稿前先试品牌和人名。普通英语发音不错的声音,遇到产品名或混合语言短语仍可能需要调整。
2. 生成并确认声音
选择适合听众和语言的声音。不看面孔,只听音频。检查发音、节奏、情绪和最后一个词,再调整文字或支持的声音设置。
生成图片动画前,保存确认好的音频。若平台整合阶段并提供声音预览,就先使用预览。若没有,就从短片开始,避免小改词也要重做长视频。
3. 生成肖像动画并检查导出
把确认好的音频上传到说话照片流程,或使用平台支持的文案输入方式。检查所选模型、计费时长、裁切和导出条件。把设置与源文件一起记录。
正常速度观看结果。检查首句、停顿和最后闭嘴动作,再看整张脸和脖子。如果面部身份发生变化,应换更清晰的源图或其他流程,不要直接认定是声音的问题。
渲染前先优化营销文案
比较以下原创示例:
| 初稿 | 口语版本 | 修改的作用 |
|---|---|---|
| 我们的平台实现全面的工作流程优化。 | 把团队的下一项任务放进一份共享清单。 | 给听众具体动作 |
| 请导航至设置部分继续操作。 | 打开设置。然后选择语言。 | 建立清晰的语句停顿 |
| 10/31之前节省20%。 | 十月三十一日之前,节省百分之二十。 | 减少数字读法歧义 |
这些是写作示例,不代表所有声音都需要把数字展开。请预听实际输出,保留意思准确、清楚自然的版本。
短产品介绍可用三部分模板:帮助谁、当前要做什么、下一步行动。例如:“在管理小班课程?把课程清单放到同一处。打开模板,添加第一项活动。”肖像段应适当简短,让产品演示负责具体说明。
若已有完整录音,可跳过 TTS,把文件交给说话照片工具。重点是确认声音,而不是强迫所有项目都经过合成语音阶段。
应如何添加停顿?
先使用普通标点。句号通常比逗号带来更明显的边界,但具体表达取决于模型。短句比塞满停顿标记的长句更容易修改。
有些引擎支持 SSML 停顿、音频标签或其他控制。不要假定这些语法可以互换。给某个模型的指令,可能被另一个忽略,甚至直接读出来。
ElevenLabs TTS 文档区分了不同语音模型和功能。添加标签前查看对应模型说明。若功能提供专门的停顿控制,先做短预览,并保留通过确认的结果。
例如,纯文本“打开设置。然后选择语言。”适合作为通用起点。只有引擎明确支持相应 SSML 语法,才应使用 <break time="500ms"/> 之类的标签。此例请求半秒停顿,不是所有引擎通用的指令。
应选择哪条工具流程?
| 起点 | 可调查的流程 | 主要边界 |
|---|---|---|
| 有文案和肖像,没有录音 | 集成文字输入的说话照片流程 | 预听生成声音并确认模型 |
| 已确认的外部 TTS 音频 | 上传音频到照片工具 | 保持准确时间和声音使用权 |
| 需要可辨识的个人声音 | 获准的声音克隆加照片动画 | 分别取得声音与肖像同意 |
| 需要多种语言 | 母语者审核的文案和对应语言声音 | 不能从可用推断质量一致 |
D-ID Studio 页面说明了头像视频的文字、音频和静态图片输入。HeyGen 对口型页面在已有视频流程之外,也介绍了文字稿和照片头像。Sync 图片指南介绍了 sync-3 的文案与声音选项。
这些官方说明足以作为调查流程的依据,却不是写实程度对比证据。利益披露: 本文由 LipSyncX 发布,我们提供商业说话照片流程。本文不声称独立的同输入质量排名。
语言数量代表什么?
语言支持依模型而定。2026年10月25日查阅的 ElevenLabs 文档列出 Flash v2.5 支持32种语言、Multilingual v2 支持29种,新模型家族则列出不同总数。应记录具体模型,不能说每个声音都支持宣传中最大的数量。
视频平台也需同样谨慎。上传音频、翻译或预设声音支持的语言,不一定适用于每种克隆或头像模式。请在实际流程中确认需要的组合。
多语言内容应请母语者确认文字并听生成音频。试片包含人名、日期和技术词。嘴形看起来合理,不能证明译文准确。
声音许可与肖像许可分开确认
有人可能同意展示照片,却不同意被归属新的发言。配音演员可能许可某段录音,却不允许声音克隆。为客户生成素材前,写明用途、传播渠道、期限和商业范围。
使用可辨识的声音克隆前,取得本人或授权权利人的明确许可。把同意记录、源素材和处理更正或撤回请求的联系人一起保存。不要暗示生成的发言是真实录音。
也要检查工具条款和数据处理方式。浏览器工具通常上传文件处理,删除或训练规则可能依套餐不同。处理敏感或付费项目时,参阅人脸上传安全指南、训练与留存指南及商用指南。
针对出问题的阶段排查
产品名读错,就修改或重新生成声音。声音清楚但太快,就缩短文案或使用支持的节奏控制。面孔漂移或牙齿闪烁,就检查源图与视觉模型。
停顿时嘴还在动,就记录时间点,检查时间或模型选项。最后一个词被截断,就比较音频、提交片段和导出的时长。不要同时改多个变量,否则不知道哪项调整有效。
短试片能让排查更可控。把拒收尝试保留作证据,再保存通过的录音和图片设置。大型项目可参考生成器候选清单,寻找合适流程,而不用从头重写文案。
常见问题
不用麦克风,也能通过文字转语音让照片说话吗?
可以。从文案生成获准使用的合成声音,再用音频或集成文字流程生成照片动画。
必须克隆自己的声音吗?
不必。预设或设计的声音也可以。克隆是可选项,需要额外授权与功能支持。
每个文本框都可以输入 SSML 吗?
不可以。只有具体引擎和模型明确支持时才用 SSML 或音频标签,否则先用普通文字和标点。
翻译文案能保持相同时长吗?
不一定。各语言的短语长度和节奏不同。生成面孔前,先确认适合朗读的改写,并测量实际音频。
写实面孔会让声音更自然吗?
它可能影响感受,却修复不了发音或节奏。检查动画前,单独听音频。
生成动画前先确认两句话
写一段短信息,包含听众需要的实际名字和数字。把文案交给说话照片工具,预听声音;只有音频准确表达你的意思后,才生成短肖像视频。
更新日志
- 2026-10-25: 核查官方文字、音频、图片流程及模型限定的 TTS 语言信息。加入适合口播的文案示例、有条件的 SSML 指引,以及声音和肖像分别授权的检查。