
用自己的歌曲制作多个对口型表演镜头
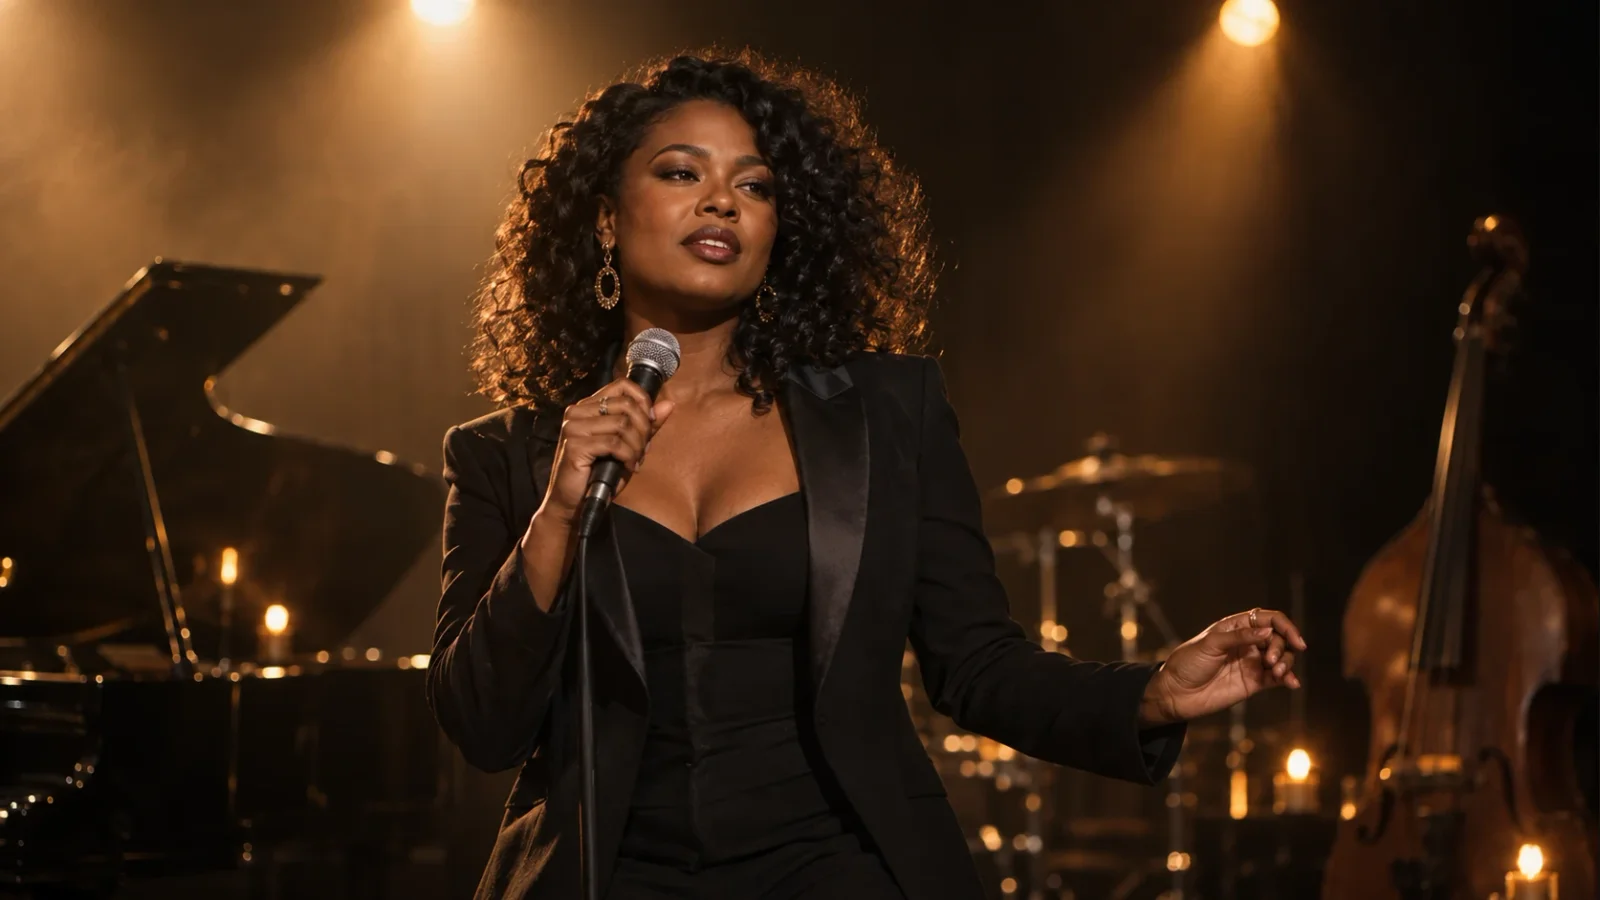
两个表演镜头单独看都可能可信,放进歌曲却不同步。解决方法要从生成前开始:为每段音频保留准确的源时间范围,再将成片放回剪辑中的相同位置。这套流程按 2026 年 10 月的产品状态编写,建议先做 5–10 秒测试。
这份 2026 年 10 月指南用一段原创合成短旋律和 LipSyncX 自有虚构表演者图片演示。它是简单的节奏测试,并非商业歌曲、客户音轨,也不声称模型会自动剪好完整音乐视频。
1. 保留一份主音频文件
使用自己拥有或获准发布的歌曲和录音。导出最终母带后,制作表演片段期间不要改变时间结构。后续修改速度、前奏长度或人声版本,早期生成的视频可能不再匹配。
小型演示使用原创合成人声短句和新编伴奏。刻意保持简单,是为了更容易检查同步,并非专业演唱音色展示。
2. 截取音频前先做镜头记录
记录母带上的准确起止时间,不要只写“副歌片段”而没有数字。下面是规划示例,并非每个演示文件的实测时间。
| 文件 | 母带起点 | 母带终点 | 用途 |
|---|---|---|---|
| verse-a | 00:12.000 | 00:20.000 | 第一个表演镜头 |
| chorus-a | 00:36.000 | 00:44.000 | 副歌特写 |
| chorus-b | 00:36.000 | 00:44.000 | 同一句的备选版本 |
两个副歌片段使用相同音频范围,才能在歌曲同一位置互为替换。如果词前包含短暂预留段,也要记录,它属于偏移量计算的一部分。
3. 选择嘴部清楚的表演图片
避免麦克风、手遮嘴、大幅侧面或过小的脸。大量制作前,用一张静图和一句短句测试。如果要同一表演者贯穿多个镜头,使用自己一致的源图片;对口型生成不能保证无关肖像之间的身份一致。
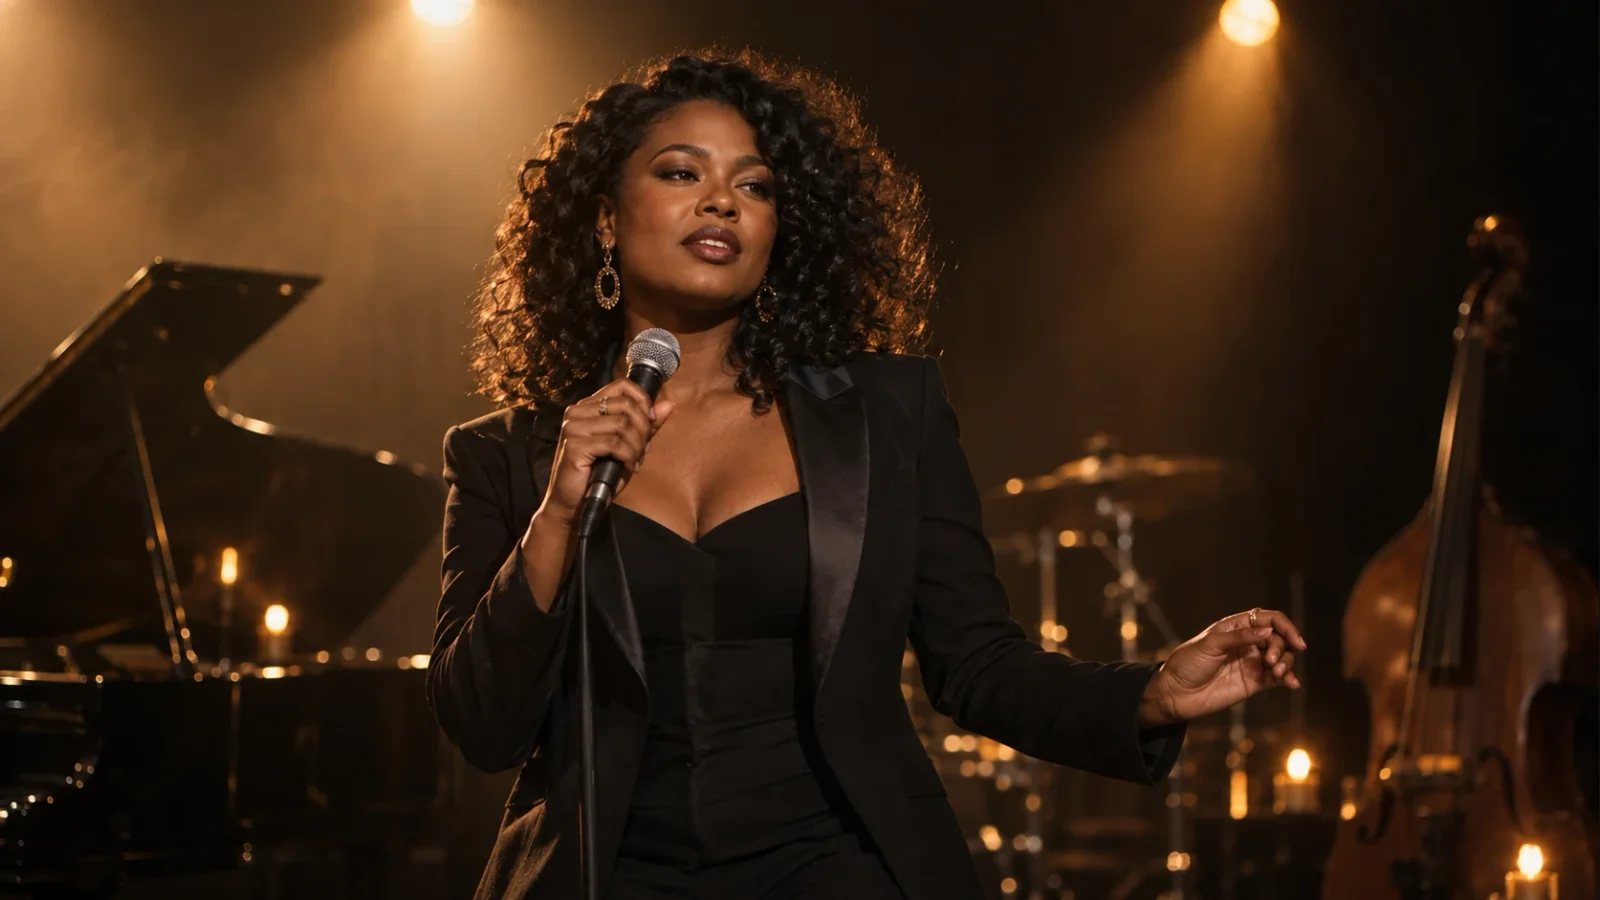
两个示例刻意使用不同虚构表演者,作为同一测试音频的视觉备选,并非同一个人的两个摄影机机位。
4. 上传短片段并查看报价
打开让照片唱歌,上传表演者图片,选择音频输入,载入准确截取的片段。回听确认第一个音节完整。需要更短测试时用音频裁剪工具,源时间偏移量另外保留。
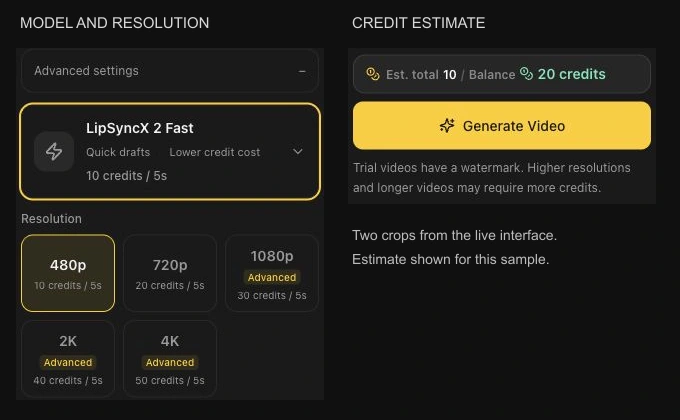
表演测试使用 LipSyncX 2 Fast,480p。生成前检查实际任务的模型、分辨率和预计积分,参考当前价格规划备选版本。新的一次生成可能消耗积分,即使最终决定不用。
制作歌曲其余部分前,先生成一个简短表演镜头。密集和声、快速辅音和嘴部遮挡,都会增加判断同步及嘴型的难度。
5. 比较两个原创测试版本
舞台表演测试 · 备选表演者测试 · 原创测试音频
两个片段都使用同一原创英语合成音频的开头,因此源偏移量都是 0 秒。它们是视觉备选测试,并非完成的蒙太奇。听闭唇和元音,检查完整输出中的面部变形及结尾截断。
6. 将每段视频对齐主音轨
只导入一次母带,把它作为主要时间线参照。每段生成视频放到记录的母带起点。用自带音频检查对齐后,将其静音,否则重复声音可能产生回声。
替换版本时,只替换同一时间段的画面,母带保持不动。不要拉伸生成表演去填另一个段落。台词不对时,重新准确裁剪输入并生成。
最终检查时,听每个切点前后,观察紧邻切点的嘴部。标题、补充镜头和转场在剪辑软件添加。更广的场景制作可参见 AI 音乐视频生成器,其输入要求与简单静图表演不同。
常见问题
可以使用其他音乐工具制作的歌曲吗?
使用有权发布的录音,导出最终音频,保留准确源时间码。流程不要求歌曲来自特定生成器。
每个镜头都应该上传完整歌曲吗?
短片段更方便检查一句演唱并控制剪辑偏移。生成较长片段前,查看当前模型限制。
两张无关肖像会像同一个歌手吗?
没有这种身份保证。要么使用同一表演者的一致获授权图片,要么明确把不同角色当成不同表演者。
首次单镜头操作可参见用自己的音频让照片唱歌。准备一个带时间码的片段,测试表演镜头。