
टेक्स्ट-टू-स्पीच से फ़ोटो बुलवाएँ: माइक्रोफ़ोन के बिना
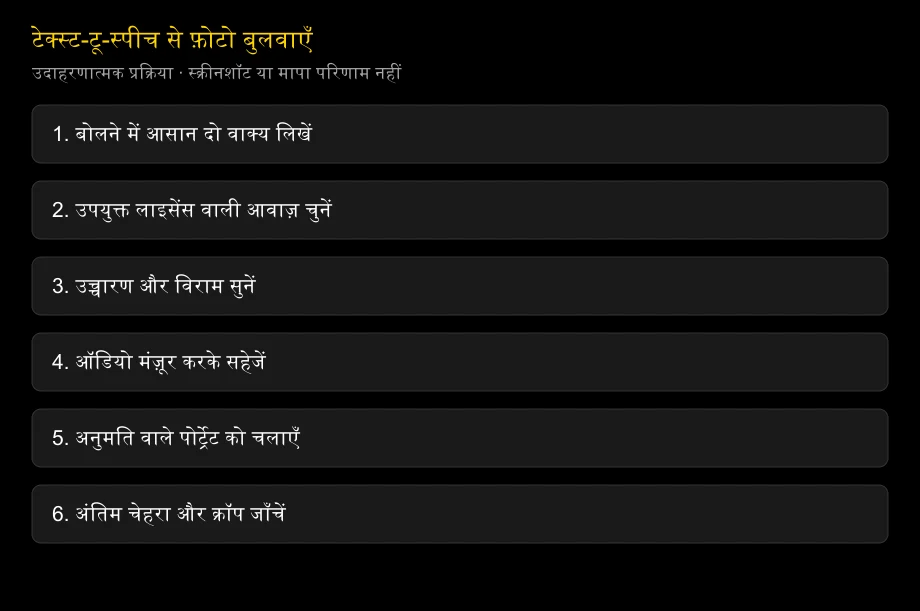
हाँ, अपनी रिकॉर्डिंग किए बिना टेक्स्ट-टू-स्पीच से फ़ोटो बुलवा सकते हैं। स्क्रिप्ट लिखें, लाइसेंस प्राप्त आवाज़ बनाएँ और मंज़ूर करें, फिर ऑडियो को तस्वीर से बोलता वीडियो बनाने वाले टूल में दें। कुछ प्लेटफ़ॉर्म तीनों चरण जोड़ते हैं, लेकिन चेहरे से पहले आवाज़ जाँचना अनावश्यक री-रेंडर रोकता है।
जाँच की तारीख: 2026-10-25। यह गाइड D-ID, HeyGen, Sync और ElevenLabs के आधिकारिक विवरण देखती है। भाषाएँ और विराम नियंत्रण चुने गए आवाज़ मॉडल पर निर्भर हैं; कंपनी की सामान्य प्रचार संख्या से इनका अनुमान न लगाएँ।
भरोसेमंद क्रम स्क्रिप्ट, आवाज़, फिर चेहरा है। सही सिंक वाला मुँह भी गलत उच्चारण कर सकता है, इसलिए एनिमेशन से पहले ऑडियो मंज़ूर करें।
शुरू करने से पहले क्या चाहिए
अनुमति वाला पोर्ट्रेट, छोटी स्क्रिप्ट और आपके उद्देश्य के लिए अनुमत आवाज़ तैयार करें। साफ़ सामने वाला चेहरा और बिना रुकावट दिखता मुँह पहली जाँच के लिए अच्छा है। पूरी ठुड्डी और अंतिम क्रॉप के लिए आसपास जगह रखें।
सामान्य टेक्स्ट-टू-स्पीच को माइक्रोफ़ोन नहीं चाहिए। आवाज़ क्लोनिंग वैकल्पिक है और अतिरिक्त सहमति माँगती है। किसी खास व्यक्ति की नकल न करनी हो तो तैयार या डिज़ाइन की गई आवाज़ उचित हो सकती है।
मूल तस्वीर, पाठ, अंतिम ऑडियो और सेटिंग साथ रखें। शब्द बदलें तो पुराने ऑडियो को मिटाने के बजाय नया संस्करण सहेजें। इससे नए कैप्शन के साथ पुरानी रिकॉर्डिंग जोड़ने से बचना आसान होता है।
तीन चरणों में फ़ोटो बुलवाएँ
1. पढ़ने के बजाय सुनने के लिए लिखें
एक वाक्य में एक विचार रखें और मुख्य काम जल्दी बताएँ। सिंथेटिक आवाज़ बोलने वाली हो तब भी खुद ज़ोर से पढ़ें। अपने शब्द समझने के लिए रुकना पड़े तो श्रोता को भी शायद रुकना पड़ेगा।
पहली स्क्रिप्ट लगभग दो छोटे वाक्य हो सकती है। उदाहरण: “कार्यस्थान में आपका स्वागत है। चेकलिस्ट खोलें और पहला काम चुनें।” यह मौलिक स्क्रिप्ट उदाहरण है, उत्पाद का रिकॉर्ड किया हुआ परिणाम नहीं।
संख्या या संक्षिप्त रूप गलत पढ़े जाएँ तो उन्हें शब्दों में लिखें। पूरी स्क्रिप्ट से पहले असली ब्रांड और व्यक्ति के नाम जाँचें। सामान्य अंग्रेज़ी अच्छी बोलने वाली आवाज़ को भी उत्पाद नाम या मिश्रित भाषा में मदद चाहिए हो सकती है।
2. आवाज़ बनाएँ और मंज़ूर करें
श्रोता और भाषा के अनुसार आवाज़ चुनें। चेहरा देखे बिना सुनें। उच्चारण, गति, भाव और अंतिम शब्द जाँचकर पाठ या समर्थित आवाज़ सेटिंग बदलें।
तस्वीर एनिमेट करने से पहले मंज़ूर ऑडियो सहेजें। संयुक्त प्लेटफ़ॉर्म में आवाज़ प्रीव्यू मिले तो इस्तेमाल करें। न मिले तो छोटा परीक्षण करें ताकि मामूली शब्द-सुधार के लिए लंबा वीडियो फिर न बनाना पड़े।
3. पोर्ट्रेट एनिमेट करके एक्सपोर्ट जाँचें
मंज़ूर ऑडियो बोलती फ़ोटो प्रक्रिया में अपलोड करें या समर्थित स्क्रिप्ट इनपुट लें। चुना मॉडल, कोट की अवधि, क्रॉप और एक्सपोर्ट शर्तें जाँचें। मूल फ़ाइलों के साथ सेटिंग लिखें।
नतीजा सामान्य गति पर देखें। पहला वाक्यांश, विराम और आखिरी मुँह बंद होना जाँचें, फिर पूरा चेहरा और गर्दन देखें। पहचान बदलती हो तो आवाज़ को दोष देने के बजाय साफ़ तस्वीर या दूसरा रास्ता आज़माएँ।
रेंडर से पहले मार्केटिंग स्क्रिप्ट सुधारें
इन मौलिक उदाहरणों की तुलना करें:
| मसौदा | बोलने वाला संस्करण | सुधार का लाभ |
|---|---|---|
| हमारा प्लेटफ़ॉर्म व्यापक वर्कफ़्लो ऑप्टिमाइज़ेशन सक्षम करता है। | टीम का अगला काम एक साझा चेकलिस्ट में रखें। | सुनने वाले को ठोस काम बताता है |
| आगे बढ़ने के लिए सेटिंग अनुभाग पर जाएँ। | सेटिंग खोलें। फिर भाषा चुनें। | स्पष्ट वाक्यांश विराम बनाता है |
| 10/31 से पहले 20% बचाएँ। | इकतीस अक्टूबर से पहले बीस प्रतिशत बचाएँ। | संख्याएँ पढ़ने की अस्पष्टता घटाता है |
ये लेखन उदाहरण हैं, हर आवाज़ को संख्या शब्दों में लिखने की आवश्यकता का दावा नहीं। असली परिणाम सुनें और सही अर्थ साफ़ व स्वाभाविक बोलने वाला संस्करण रखें।
छोटे उत्पाद परिचय में तीन हिस्से रखें: किसकी मदद, तुरंत किया जाने वाला काम और अगला कदम। जैसे: “छोटी कक्षा संभालते हैं? पाठ की चेकलिस्ट एक जगह रखें। टेम्पलेट खोलकर पहली गतिविधि जोड़ें।” पोर्ट्रेट छोटा रखें ताकि उत्पाद प्रदर्शन विवरण समझाए।
तैयार रिकॉर्डिंग हो तो TTS छोड़कर फ़ाइल बोलती फ़ोटो टूल में लें। उद्देश्य आवाज़ मंज़ूर करना है, हर प्रोजेक्ट को सिंथेटिक आवाज़ से गुज़ारना नहीं।
विराम कैसे जोड़ें?
सामान्य विराम चिह्नों से शुरू करें। पूर्ण विराम आम तौर पर अल्पविराम से मज़बूत सीमा देता है, लेकिन असली प्रस्तुति मॉडल पर निर्भर है। विराम संकेतों से भरी लंबी लाइन की तुलना में छोटे वाक्य सुधारना आसान है।
कुछ इंजन SSML ब्रेक, ऑडियो टैग या दूसरे नियंत्रण देते हैं। इनकी सिंटैक्स को आपस में बदलने योग्य न मानें। एक मॉडल का आदेश दूसरा अनदेखा कर सकता है या बोलकर पढ़ सकता है।
ElevenLabs का TTS दस्तावेज़ मॉडल और क्षमताएँ अलग बताता है। टैग से पहले ठीक मॉडल का दस्तावेज़ पढ़ें। अलग विराम नियंत्रण समर्थित हो तो छोटा प्रीव्यू सुनकर मंज़ूर परिणाम रखें।
मसलन सामान्य पाठ “सेटिंग खोलें। फिर भाषा चुनें।” एक आसानी से स्थानांतरित शुरुआत है। <break time="500ms"/> जैसा टैग केवल उस इंजन में उचित है जो वह SSML सिंटैक्स स्पष्ट रूप से समर्थित बताता है। यह आधे सेकंड का विराम माँगता है, सर्वमान्य आदेश नहीं।
कौन-सा टूल रास्ता चुनें?
| शुरुआती स्थिति | देखने योग्य रास्ता | मुख्य सीमा |
|---|---|---|
| स्क्रिप्ट और पोर्ट्रेट, रिकॉर्डिंग नहीं | टेक्स्ट वाला एकीकृत बोलती फ़ोटो टूल | आवाज़ सुनें और मॉडल जाँचें |
| मंज़ूर बाहरी TTS ऑडियो | फ़ोटो टूल में ऑडियो अपलोड | सटीक समय और आवाज़ अधिकार रखें |
| पहचानने योग्य निजी आवाज़ चाहिए | अनुमति वाला क्लोन और फ़ोटो एनिमेशन | आवाज़ और चेहरे की सहमति अलग लें |
| कई भाषाएँ चाहिए | मूल वक्ता से जँची स्क्रिप्ट और भाषा की आवाज़ें | उपलब्धता से समान गुणवत्ता न मानें |
D-ID का Studio पेज अवतार वीडियो के लिए पाठ, ऑडियो और स्थिर तस्वीर बताता है। HeyGen का लिप-सिंक पेज फुटेज के साथ टाइप की स्क्रिप्ट और फ़ोटो अवतार भी बताता है। Sync का तस्वीर गाइड sync-3 के स्क्रिप्ट और आवाज़ विकल्प समझाता है।
ये आधिकारिक विवरण रास्ते की जाँच का आधार हैं, यथार्थवाद की तुलना के प्रमाण नहीं। खुलासा: LipSyncX यह लेख प्रकाशित करता है और व्यावसायिक बोलती फ़ोटो प्रक्रिया देता है। समान इनपुट वाली स्वतंत्र गुणवत्ता रैंकिंग का दावा नहीं है।
भाषा की संख्याओं का क्या अर्थ है?
समर्थन मॉडल के अनुसार है। 25 अक्टूबर 2026 को देखे ElevenLabs दस्तावेज़ में Flash v2.5 के लिए 32 भाषाएँ और Multilingual v2 के लिए 29 हैं; नए मॉडल समूहों में अलग कुल हैं। हर आवाज़ को सबसे बड़ी प्रचार संख्या देने के बजाय ठीक मॉडल लिखें।
वीडियो प्लेटफ़ॉर्म पर भी यही सावधानी रखें। अपलोड किए ऑडियो, अनुवाद या तैयार आवाज़ की भाषा हर क्लोन या अवतार में नहीं हो सकती। असली प्रक्रिया में आवश्यक संयोजन जाँचें।
बहुभाषी सामग्री में मूल वक्ता से पाठ मंज़ूर कराएँ और ऑडियो सुनवाएँ। परीक्षण में नाम, तारीखें और तकनीकी शब्द रखें। उचित दिखता मुँह सही अनुवाद का प्रमाण नहीं।
आवाज़ और चेहरे की अनुमति अलग रखें
कोई व्यक्ति तस्वीर दिखाने को मान सकता है, लेकिन नई बात उसकी बताने को नहीं। आवाज़ कलाकार रिकॉर्डिंग की अनुमति दे सकता है, क्लोन की नहीं। ग्राहक के लिए सामग्री से पहले उद्देश्य, वितरण, अवधि और व्यावसायिक दायरा लिखें।
पहचानने योग्य क्लोन के लिए व्यक्ति या अधिकृत अधिकारधारक से स्पष्ट अनुमति लें। सहमति स्रोत सामग्री और सुधार या वापसी के संपर्क के साथ रखें। उत्पन्न बयान को असली रिकॉर्डिंग होने का संकेत न दें।
टूल की शर्तें और डेटा व्यवहार भी देखें। ब्राउज़र टूल आम तौर पर फ़ाइलें अपलोड करते हैं; मिटाने या प्रशिक्षण के नियम प्लान से बदल सकते हैं। संवेदनशील या भुगतान वाले काम में चेहरा अपलोड सुरक्षा, प्रशिक्षण और संग्रह, व्यावसायिक उपयोग गाइड देखें।
जिस चरण में दोष हो, वही सुधारें
उत्पाद नाम गलत हो तो आवाज़ बदलें या दोबारा बनाएँ। साफ़ लेकिन तेज़ हो तो स्क्रिप्ट घटाएँ या समर्थित गति नियंत्रण लें। चेहरा बदले या दाँत झिलमिलाएँ तो तस्वीर और दृश्य मॉडल देखें।
विराम में मुँह चले तो टाइमकोड सहेजकर समय या मॉडल सेटिंग जाँचें। आखिरी शब्द कटे तो ऑडियो, भेजे क्लिप और एक्सपोर्ट की अवधि तुलना करें। एक साथ कई चीज़ें न बदलें, वरना मदद करने वाला सुधार पता नहीं चलेगा।
छोटा परीक्षण काम को सँभालने योग्य बनाता है। अस्वीकृत प्रयास प्रमाण की तरह रखें और मंज़ूर रिकॉर्डिंग व सेटिंग बचाएँ। बड़े प्रोजेक्ट में जनरेटर सूची पूरा स्क्रिप्ट काम दोहराए बिना दूसरा उपयुक्त रास्ता खोजती है।
अक्सर पूछे जाने वाले सवाल
क्या बिना माइक्रोफ़ोन टेक्स्ट से फ़ोटो बुलवा सकते हैं?
हाँ। स्क्रिप्ट से लाइसेंस वाला सिंथेटिक स्वर बनाएँ और उसी ऑडियो या एकीकृत टेक्स्ट से फ़ोटो एनिमेट करें।
अपनी आवाज़ क्लोन करना ज़रूरी है?
नहीं। तैयार या डिज़ाइन किए स्वर काम कर सकते हैं। क्लोनिंग वैकल्पिक है, अलग अनुमति और फीचर चाहिए।
हर टेक्स्ट बॉक्स में SSML डाल सकते हैं?
नहीं। केवल ठीक इंजन और मॉडल के दस्तावेज़ में समर्थन हो तो SSML या टैग लें। अन्यथा सामान्य भाषा और विराम चिह्नों से शुरू करें।
अनुवाद में समय वही रहेगा?
ज़रूरी नहीं। भाषाओं में वाक्यांश की लंबाई और लय बदलती है। बोलने योग्य रूपांतरण मंज़ूर कर असली ऑडियो मापें, फिर चेहरा बनाएँ।
यथार्थ चेहरा आवाज़ अधिक स्वाभाविक करता है?
प्रभाव बदल सकता है, लेकिन उच्चारण या गति नहीं सुधारता। एनिमेशन से पहले सिर्फ ऑडियो सुनें।
एनिमेशन से पहले दो वाक्य मंज़ूर करें
श्रोताओं के लिए ज़रूरी असली नाम और संख्या वाला छोटा संदेश लिखें। बोलती फ़ोटो टूल में आवाज़ सुनें और ठीक चाहा अर्थ मिलने पर ही छोटा पोर्ट्रेट वीडियो बनाएँ।
बदलाव का विवरण
- 2026-10-25: आधिकारिक पाठ, ऑडियो, तस्वीर प्रक्रियाएँ और मॉडल-विशिष्ट TTS भाषाएँ जाँचीं। मौखिक उदाहरण, सशर्त SSML निर्देश और आवाज़ व चेहरे की अलग अनुमति जाँच जोड़ीं।