
Faire parler une photo avec la synthèse vocale : sans microphone
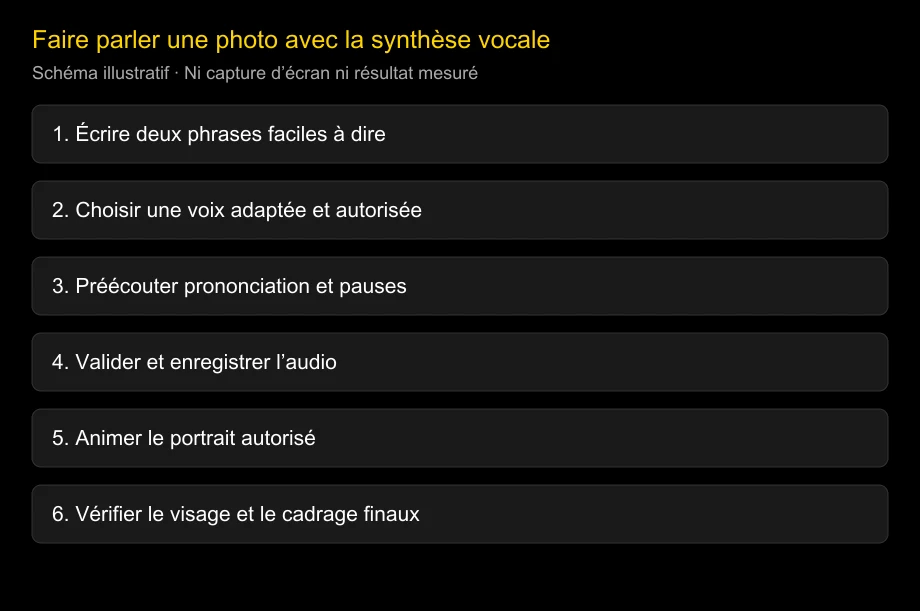
Oui, vous pouvez faire parler une photo avec la synthèse vocale sans vous enregistrer. Écrivez le texte, générez et validez une voix sous licence, puis utilisez cet audio avec un outil transformant une image en vidéo parlante. Certains services réunissent les trois étapes, mais vérifier la voix avant le visage évite des générations inutiles.
Vérifié le 2026-10-25. Ce guide consulte les descriptions officielles de D-ID, HeyGen, Sync et ElevenLabs. Les langues et les pauses dépendent du modèle vocal choisi ; une annonce générale de l’entreprise ne suffit pas.
L’ordre fiable est texte, voix, puis visage. Une bouche bien synchronisée peut encore mal prononcer : validez l’audio avant d’évaluer l’animation.
Ce qu’il faut préparer
Prévoyez un portrait autorisé, un court texte et une voix utilisable pour l’objectif prévu. Un visage net de face, à la bouche dégagée, convient au premier essai. Gardez tout le menton et de la marge pour le recadrage final.
La synthèse vocale ordinaire ne nécessite pas de microphone. Le clonage est facultatif et ajoute des obligations de consentement. Une voix de catalogue ou conçue peut convenir sans reproduire une personne précise.
Conservez ensemble image source, texte, audio final et réglages. Si le texte change, créez une nouvelle version audio au lieu d’écraser l’ancienne. Vous éviterez plus facilement des sous-titres nouveaux associés à un ancien enregistrement.
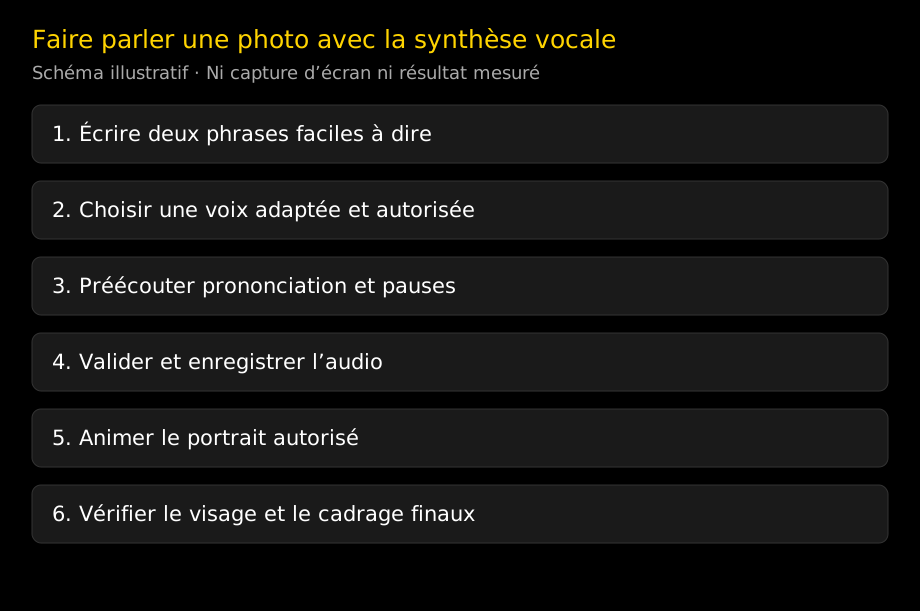
Faire parler la photo en trois étapes
1. Écrire pour l’oreille, pas pour la page
Gardez une idée par phrase et placez tôt l’action principale. Lisez à voix haute même si une voix synthétique parlera. Si vous devez vous arrêter pour comprendre votre formulation, l’auditeur le devra probablement aussi.
Deux phrases courtes constituent un bon premier texte. Exemple : « Bienvenue dans l’espace de travail. Ouvrez votre liste, puis choisissez la première tâche. » C’est un exemple original, pas un résultat enregistré du produit.
Écrivez nombres et abréviations en toutes lettres si la voix les lit mal. Testez les vrais noms de marques et de personnes avant tout le texte. Une bonne prononciation de l’anglais courant ne garantit pas celle d’un produit ou d’une expression multilingue.
2. Générer et valider la voix
Choisissez une voix adaptée au public et à la langue. Écoutez sans regarder de visage. Vérifiez prononciation, rythme, émotion et dernier mot, puis modifiez le texte ou les paramètres pris en charge.
Enregistrez l’audio validé avant d’animer l’image. Si le service intègre les étapes et propose une préécoute, utilisez-la. Sinon, commencez court pour qu’une petite correction ne force pas à refaire une longue vidéo.
3. Animer le portrait et vérifier l’export
Importez l’audio validé dans un outil de photo parlante ou utilisez sa saisie de texte compatible. Vérifiez modèle, durée facturée annoncée, recadrage et conditions d’export. Notez les réglages avec les sources.
Regardez à vitesse normale. Inspectez première phrase, pauses et fermeture finale, puis tout le visage et le cou. Si l’identité change, essayez une source plus nette ou une autre méthode au lieu d’accuser la voix.
Améliorer un texte marketing avant génération
Comparez ces exemples originaux :
| Brouillon | Version orale | Intérêt de la modification |
|---|---|---|
| Notre plateforme permet une optimisation globale des processus. | Placez la prochaine tâche de l’équipe dans une liste partagée. | Donne une action concrète |
| Veuillez accéder à la section des paramètres pour continuer. | Ouvrez les paramètres. Puis choisissez votre langue. | Crée une séparation claire |
| Économisez 20% avant le 10/31. | Économisez vingt pour cent avant le trente et un octobre. | Réduit les ambiguïtés de lecture des nombres |
Ce sont des exemples de rédaction, pas une obligation d’écrire tous les nombres en lettres. Écoutez le résultat réel et gardez la version claire, naturelle et fidèle au sens.
Pour une courte présentation, utilisez trois parties : qui est aidé, tâche immédiate et action suivante. Exemple : « Vous gérez une petite classe ? Regroupez la liste du cours au même endroit. Ouvrez le modèle et ajoutez la première activité. » Limitez la partie portrait pour laisser la démonstration expliquer les détails.
Si vous avez déjà un enregistrement fini, sautez le TTS et utilisez ce fichier dans l’outil de photo parlante. L’objectif est de valider la voix, pas d’imposer la synthèse à chaque projet.
Comment ajouter des pauses ?
Commencez par une ponctuation normale. Un point marque généralement une coupure plus forte qu’une virgule, même si le rendu dépend du modèle. Une phrase courte se révise mieux qu’une longue ligne remplie de balises de pause.
Certains moteurs prennent en charge pauses SSML, balises audio ou autres contrôles. Ne présumez pas leur interchangeabilité. Une instruction destinée à un modèle peut être ignorée ou lue à haute voix par un autre.
La documentation TTS d’ElevenLabs distingue modèles et capacités. Consultez le modèle exact avant d’ajouter des balises. Si une commande de pause dédiée est disponible, testez une courte préécoute et gardez le résultat validé.
Par exemple, « Ouvrez les paramètres. Puis choisissez votre langue. » est un point de départ portable en texte simple. Une balise comme <break time="500ms"/> convient uniquement à un moteur qui accepte explicitement cette syntaxe SSML. Elle demande une demi-seconde de pause, sans être une commande universelle.
Quel parcours d’outils choisir ?
| Situation initiale | Parcours à étudier | Limite principale |
|---|---|---|
| Texte et portrait, sans enregistrement | Photo parlante avec texte intégré | Préécouter la voix et vérifier le modèle |
| Audio TTS externe validé | Importer l’audio dans un outil photo | Préserver temps exact et droits vocaux |
| Voix personnelle reconnaissable nécessaire | Clone autorisé et animation photo | Obtenir séparément les consentements voix et image |
| Plusieurs langues nécessaires | Textes revus par des natifs et voix par langue | Disponibilité ne veut pas dire qualité égale |
La page Studio de D-ID décrit texte, audio et images fixes pour des avatars vidéo. La page de synchronisation de HeyGen inclut textes saisis et avatars photo avec les parcours sur séquences. Le guide image de Sync explique les options texte et voix de sync-3.
Ces descriptions officielles justifient l’examen d’un parcours, pas une comparaison de réalisme. Transparence : LipSyncX publie cet article et propose un parcours commercial de photo parlante. Aucun classement indépendant à entrées identiques n’est revendiqué.
Que signifient les nombres de langues ?
Le support est propre au modèle. La documentation ElevenLabs consultée le 25 octobre 2026 indique 32 langues pour Flash v2.5 et 29 pour Multilingual v2 ; les nouvelles familles affichent d’autres totaux. Notez le modèle exact plutôt que d’attribuer à chaque voix la couverture maximale annoncée.
Même prudence pour les plateformes vidéo. Une langue disponible pour l’audio importé, la traduction ou une voix de catalogue peut manquer dans certains modes de clonage ou d’avatar. Vérifiez la combinaison réelle.
Pour du contenu multilingue, demandez à un locuteur natif de valider le texte et d’écouter l’audio. Incluez noms, dates et termes techniques dans l’essai. Une bouche plausible ne prouve pas une bonne traduction.
Séparer les autorisations de voix et d’image
Une personne peut accepter l’affichage de sa photo sans accepter de nouveaux propos attribués à elle. Un comédien peut licencier un enregistrement sans permettre de clone. Consignez finalité, diffusion, durée et portée commerciale avant une génération pour un client.
Pour un clone reconnaissable, obtenez l’autorisation explicite de la personne ou de l’ayant droit habilité. Conservez consentement, sources et contact pour correction ou retrait. Ne suggérez pas qu’une déclaration générée est un enregistrement réel.
Vérifiez aussi les conditions et les pratiques de données. Un outil navigateur importe généralement les fichiers ; suppression et entraînement peuvent varier selon le forfait. Pour un projet sensible ou payé, consultez les guides sécurité des visages, entraînement et conservation et usage commercial.
Corriger l’étape défaillante
Si le nom du produit est faux, révisez ou régénérez la voix. Si elle est claire mais trop rapide, raccourcissez le texte ou utilisez les réglages de rythme pris en charge. Si le visage dérive ou les dents clignotent, examinez l’image et le modèle visuel.
Si la bouche bouge pendant une pause, notez le temps et vérifiez les paramètres temporels ou le modèle. Si le dernier mot est coupé, comparez l’audio, le segment envoyé et l’export. Ne changez pas plusieurs variables à la fois : vous ne sauriez pas laquelle a aidé.
Un essai court facilite ce travail. Gardez les essais rejetés comme preuves, puis conservez audio et réglages validés. Pour un grand projet, la sélection de générateurs aide à trouver une autre méthode sans reprendre tout le texte.
Questions fréquentes
Peut-on faire parler une photo avec la synthèse vocale sans microphone ?
Oui. Générez une voix synthétique autorisée depuis le texte, puis animez la photo avec l’audio ou une saisie de texte intégrée.
Dois-je cloner ma voix ?
Non. Une voix de catalogue ou conçue peut convenir. Le clonage est facultatif et exige une autorisation et une fonction distinctes.
Puis-je mettre du SSML dans tout champ texte ?
Non. Utilisez SSML ou balises audio uniquement si le moteur et le modèle exacts les documentent. Sinon, partez de texte simple et de ponctuation.
La traduction conserve-t-elle la même durée ?
Pas forcément. Les langues ont des longueurs et rythmes différents. Validez une adaptation prononçable et mesurez l’audio avant de créer le visage.
Un visage réaliste rend-il la voix plus naturelle ?
Il peut changer l’impression, mais ne corrige ni prononciation ni rythme. Écoutez l’audio seul avant l’animation.
Valider deux phrases avant d’animer
Écrivez un court message avec les vrais noms et nombres nécessaires. Apportez-le à l’outil de photo parlante, préécoutez la voix et ne générez le portrait que lorsque l’audio dit exactement ce qui est prévu.
Historique
- 2026-10-25 : Vérification des parcours officiels texte, audio et image et des langues TTS par modèle. Ajout d’exemples oraux, de conseils SSML conditionnels et de vérifications distinctes voix et image.