
Як змусити фото говорити через синтез мовлення: без мікрофона
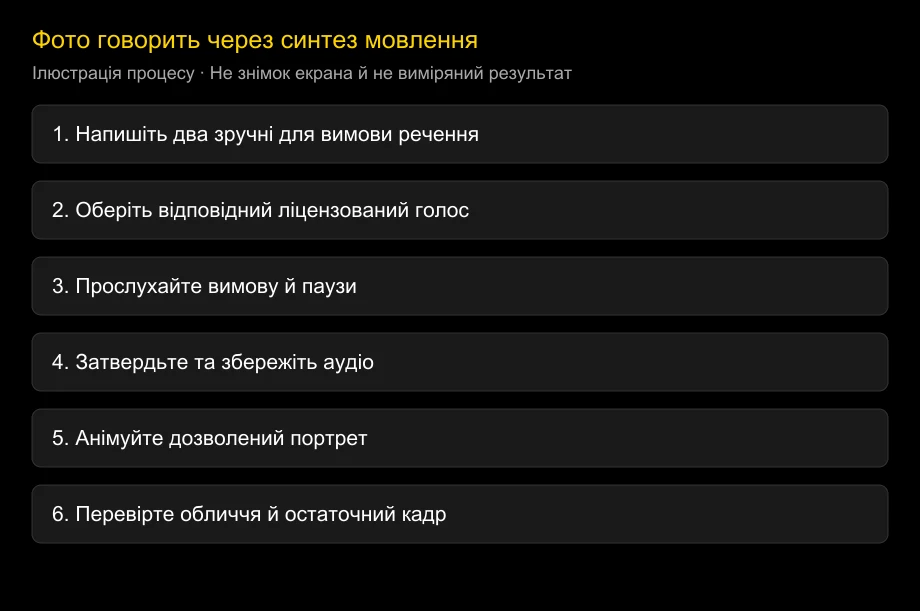
Так, фото може говорити через синтез мовлення без запису власного голосу. Напишіть текст, створіть і затвердьте ліцензований голос, потім використайте аудіо в інструменті створення відео з нерухомого зображення. Деякі платформи поєднують три етапи, але перевірка голосу до обличчя запобігає зайвим повторним генераціям.
Перевірено: 2026-10-25. Посібник розглядає офіційні описи D-ID, HeyGen, Sync та ElevenLabs. Підтримка мов і пауз залежить від голосової моделі, а не від загального рекламного заголовка компанії.
Надійна послідовність: текст, голос, обличчя. Навіть синхронізований рот може вимовляти неправильно, тож затвердьте звук перед оцінкою анімації.
Що потрібно перед початком
Підготуйте дозволений портрет, короткий текст і голос, який можна застосовувати для вашої мети. Для першої проби підходить чітке обличчя анфас із відкритим ротом без перешкод. Залиште все підборіддя й простір для фінального кадрування.
Звичайний синтез мовлення не потребує мікрофона. Клонування необов’язкове й вимагає додаткової згоди. Готовий або розроблений голос підійде, якщо не потрібно відтворювати конкретну людину.
Тримайте разом зображення, текст, фінальне аудіо й налаштування. Змінивши слова, збережіть нову версію звуку, не перезаписуючи попередню. Так легше уникнути нових субтитрів зі старим записом.
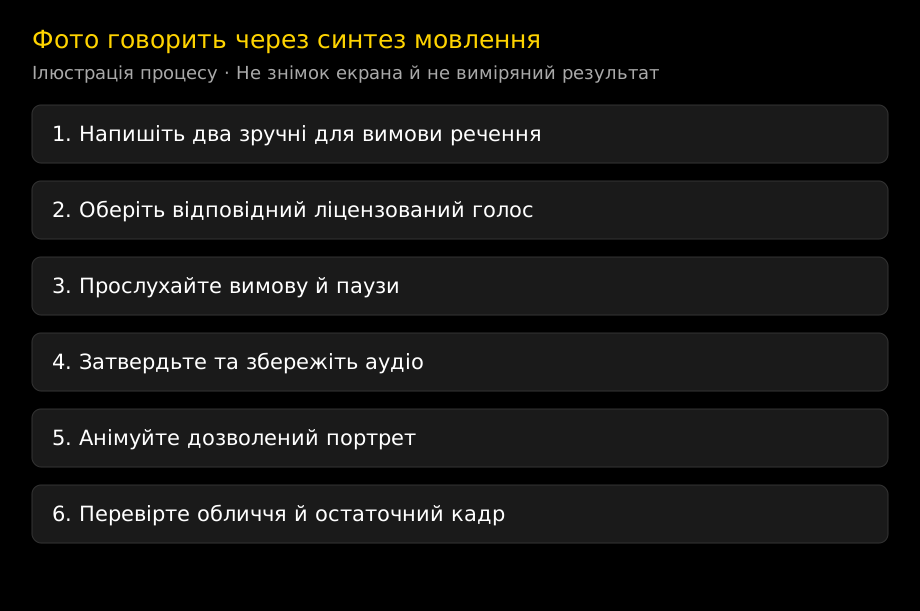
Зробіть фото, що говорить, у три етапи
1. Пишіть для слухача, а не сторінки
Одна думка на речення, головна дія — на початку. Прочитайте вголос, навіть якщо говоритиме синтетичний голос. Якщо вам треба зупинитися, щоб зрозуміти свій текст, слухачеві, ймовірно, також.
Хороший перший текст — близько двох коротких речень. Наприклад: «Вітаємо в робочому просторі. Відкрийте список і виберіть перше завдання». Це власний приклад, не записаний результат продукту.
Розпишіть числа й скорочення, якщо голос читає їх хибно. Перевірте справжні назви брендів та імена до повного тексту. Голосу з доброю звичайною англійською може знадобитися підказка для продукту чи змішаної мови.
2. Створіть і затвердьте голос
Оберіть голос для аудиторії та мови. Слухайте, не дивлячись на обличчя. Перевірте вимову, темп, емоцію й останнє слово, потім змініть текст або підтримувані параметри.
Збережіть затверджене аудіо до анімації. Якщо інтегрована платформа має попереднє прослуховування, скористайтеся ним. Інакше почніть коротко, щоб дрібна правка не потребувала переробляти довгий ролик.
3. Анімуйте портрет і перевірте експорт
Завантажте затверджене аудіо в процес фото, що говорить, або використайте підтримуваний текстовий ввід. Перевірте модель, розраховану тривалість, кадрування й умови експорту. Запишіть параметри разом із джерелами.
Дивіться зі звичайною швидкістю. Перевірте першу фразу, паузи, останнє закриття рота, потім усе обличчя та шию. Якщо зовнішність змінюється, спробуйте чіткіше джерело чи інший шлях, а не звинувачуйте голос.
Покращте рекламний текст до генерації
Порівняйте власні приклади:
| Чернетка | Усна версія | Користь зміни |
|---|---|---|
| Наша платформа забезпечує комплексну оптимізацію процесів. | Додайте наступне завдання команди до спільного списку. | Дає конкретну дію |
| Щоб продовжити, перейдіть до розділу налаштувань. | Відкрийте налаштування. Потім оберіть мову. | Створює чітку межу фраз |
| Заощадьте 20% до 10/31. | Заощадьте двадцять відсотків до тридцять першого жовтня. | Зменшує неоднозначність читання чисел |
Це приклади редагування, не вимога писати всі числа словами для кожного голосу. Прослухайте реальний результат і залиште варіант, що чітко й природно передає задум.
Короткий вступ до продукту може мати три частини: кому допомагає, поточне завдання, наступна дія. Наприклад: «Навчаєте невеликий клас? Зберіть список уроку в одному місці. Відкрийте шаблон і додайте першу вправу». Залиште портретний уривок коротким, щоб деталі пояснила демонстрація продукту.
Якщо маєте готовий запис, пропустіть TTS і використайте файл в інструменті фото, що говорить. Мета — затвердити голос, а не змушувати кожен проєкт до синтезу.
Як додавати паузи?
Почніть зі звичайної пунктуації. Крапка зазвичай дає сильнішу межу, ніж кома, хоча виконання залежить від моделі. Короткі речення легше змінити, ніж довгий рядок із маркерами пауз.
Деякі рушії підтримують паузи SSML, аудіотеги чи інші команди. Не вважайте синтаксиси взаємозамінними. Команду однієї моделі інша може ігнорувати або прочитати вголос.
Документація TTS ElevenLabs розрізняє моделі й можливості. Перед тегами прочитайте опис конкретної моделі. Якщо є окреме керування паузою, перевірте короткий уривок і збережіть затверджений результат.
Наприклад, звичайний текст «Відкрийте налаштування. Потім оберіть мову» — переносна відправна точка. Тег <break time="500ms"/> доречний лише для рушія, який явно підтримує цей SSML-синтаксис. Він просить пів секунди паузи, а не є універсальною командою.
Який шлях інструментів обрати?
| Початкова ситуація | Що дослідити | Головна межа |
|---|---|---|
| Є текст і портрет, запису немає | Інтегроване фото з текстом | Прослухайте голос і перевірте модель |
| Затверджене зовнішнє TTS-аудіо | Завантаження звуку в фотосервіс | Збережіть точний час і права на голос |
| Потрібен впізнаваний особистий голос | Дозволений клон та анімація фото | Окремо погодьте голос і зовнішність |
| Потрібно кілька мов | Тексти після перевірки носієм і відповідні голоси | Доступність не означає однакову якість |
Сторінка Studio D-ID описує текст, аудіо й зображення для аватарних відео. Сторінка синхронізації HeyGen має тексти та фотоаватари разом із відеопроцесами. Гід зображень Sync описує текст і голос для sync-3.
Офіційні описи обґрунтовують дослідження шляху, але не порівнюють реалістичність. Розкриття інтересів: LipSyncX публікує статтю й пропонує комерційний процес фото, що говорить. Незалежний рейтинг на однакових даних не заявляється.
Що означає кількість мов?
Підтримка залежить від моделі. Документація ElevenLabs, перевірена 25 жовтня 2026 року, зазначає 32 мови для Flash v2.5 і 29 для Multilingual v2; нові сімейства мають інші підсумки. Записуйте модель, а не приписуйте кожному голосу найбільше рекламоване покриття.
Така сама обережність потрібна з відеоплатформами. Мова для завантаженого аудіо, перекладу чи готового голосу може бути відсутня в певному клоні або аватарі. Перевірте потрібне поєднання в реальному процесі.
Для багатомовного матеріалу попросіть носія затвердити текст і послухати звук. Додайте до проби імена, дати й терміни. Правдоподібний рот не доводить правильність перекладу.
Відокремлюйте дозволи на голос і зовнішність
Людина може дозволити показ фото, але не нові приписані їй слова. Актор може ліцензувати запис без дозволу на клон. Запишіть мету, поширення, строк і комерційний обсяг до роботи для клієнта.
Для впізнаваного клону отримайте явний дозвіл людини або уповноваженого правовласника. Зберігайте згоду з джерелами й контактом для виправлення чи відкликання. Не створюйте враження, що згенерована заява є справжнім записом.
Перевірте також умови й практики даних інструмента. Браузер зазвичай завантажує файли, а видалення чи навчання можуть залежати від тарифу. Для чутливих або оплачуваних проєктів читайте про безпечне завантаження облич, навчання й зберігання, комерційне використання.
Виправляйте етап, що дав збій
Якщо назва продукту хибна, виправте чи заново створіть голос. Якщо мова чітка, але швидка, скоротіть текст або використайте підтримуваний темп. Якщо обличчя змінюється чи зуби мерехтять, перевірте зображення і візуальну модель.
Якщо рот рухається під час паузи, запишіть час і перевірте налаштування. Якщо обрізано останнє слово, порівняйте довжини звуку, надісланого фрагмента й експорту. Не змінюйте кілька параметрів одночасно: не зрозумієте, що допомогло.
Коротка проба спрощує роботу. Зберігайте відхилені спроби як докази та затверджені звук і параметри. Для великих проєктів список генераторів допоможе знайти інший шлях без переписування всього тексту.
Поширені запитання
Чи можна створити фото, що говорить, із тексту без мікрофона?
Так. Створіть ліцензований синтетичний голос із тексту й анімуйте фото цим аудіо або вбудованим текстовим вводом.
Чи обов’язково клонувати свій голос?
Ні. Підійдуть готові чи розроблені голоси. Клонування необов’язкове й потребує окремого дозволу та підтримки.
Чи можна вставити SSML у будь-яке поле?
Ні. Використовуйте SSML і теги лише за документованої підтримки конкретного рушія та моделі. Інакше почніть зі звичайного тексту й пунктуації.
Чи збереже переклад той самий час?
Не обов’язково. Мови мають різну довжину фраз і темп. Затвердьте зручну для вимови адаптацію та виміряйте звук до обличчя.
Чи робить реалістичне обличчя голос природнішим?
Воно може вплинути на враження, але не виправляє вимову й темп. Спершу послухайте лише звук.
Затвердьте два речення до анімації
Напишіть коротке повідомлення з потрібними справжніми іменами й числами. Відкрийте його в інструменті фото, що говорить, послухайте голос і створюйте портрет лише коли аудіо точно передає задум.
Історія змін
- 2026-10-25: Перевірено офіційні текстові, звукові та графічні процеси й мови TTS за моделями. Додано усні приклади, умовні вказівки SSML та окремі дозволи на голос і зовнішність.