
Jadikan foto bercakap melalui teks ke pertuturan: tanpa mikrofon
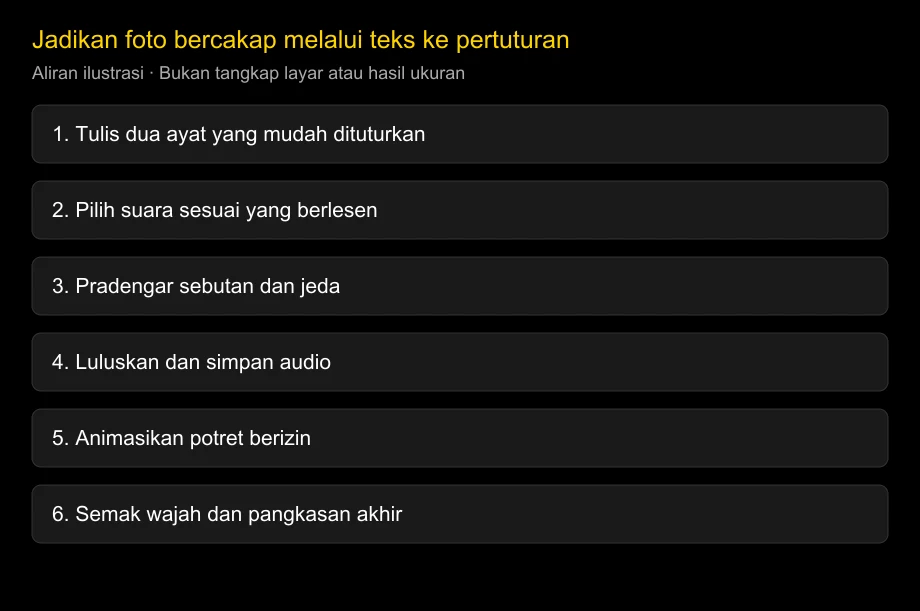
Ya, anda boleh menjadikan foto bercakap melalui teks ke pertuturan tanpa merakam diri. Tulis skrip, jana dan luluskan suara berlesen, kemudian gunakan audio itu dengan alat imej kepada video bercakap. Sesetengah platform menyatukan tiga peringkat, tetapi semakan suara sebelum wajah mengelakkan penjanaan semula yang tidak perlu.
Disemak: 2026-10-25. Panduan ini meneliti penerangan rasmi D-ID, HeyGen, Sync dan ElevenLabs. Bahasa serta kawalan jeda bergantung pada model suara, bukan tajuk promosi seluruh syarikat.
Urutan yang boleh dipercayai ialah skrip, suara, kemudian wajah. Mulut terselaras masih boleh salah sebut, jadi luluskan audio sebelum menilai animasi.
Keperluan sebelum bermula
Sediakan potret berizin, skrip pendek dan suara yang boleh digunakan bagi tujuan anda. Wajah hadapan jelas dengan mulut tidak terlindung sesuai untuk ujian pertama. Kekalkan seluruh dagu dan ruang sekeliling untuk pangkasan akhir.
Teks ke pertuturan biasa tidak memerlukan mikrofon. Pengklonan pilihan sahaja dan menambah keperluan persetujuan. Suara sedia ada atau direka boleh sesuai jika tidak perlu meniru individu tertentu.
Simpan imej sumber, teks, audio akhir dan tetapan bersama. Jika ayat berubah, simpan versi audio baharu dan jangan timpa yang lama. Ini mengelakkan sari kata baharu dipadankan dengan rakaman lama.
Jadikan foto bercakap dalam tiga peringkat
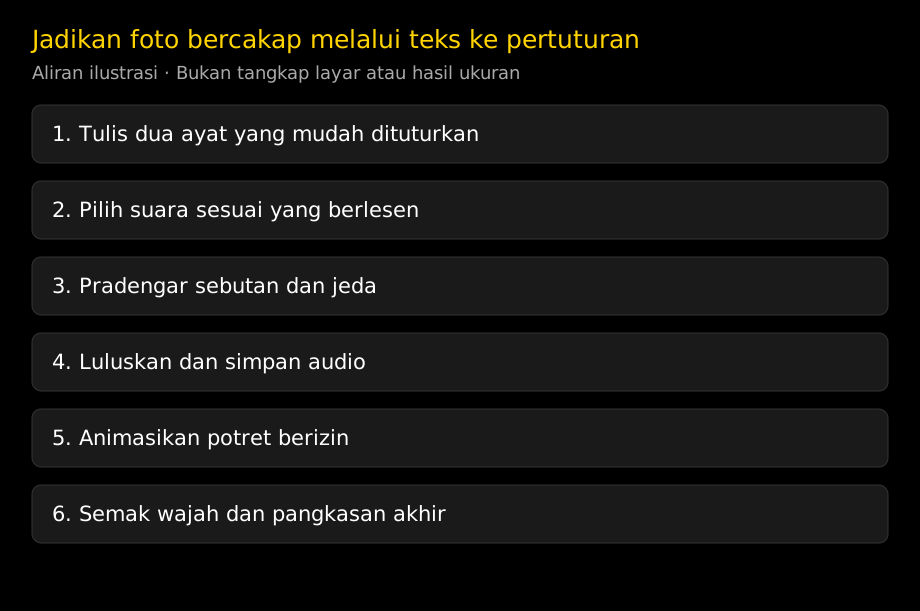
1. Tulis untuk didengar, bukan dibaca
Satu idea setiap ayat dan letakkan tindakan utama awal. Baca kuat walaupun suara sintetik akan menyampaikannya. Jika anda perlu berhenti untuk memahami tulisan sendiri, pendengar mungkin begitu juga.
Dua ayat pendek sesuai untuk skrip pertama. Contoh: “Selamat datang ke ruang kerja. Buka senarai semak dan pilih tugas pertama.” Ini contoh asli, bukan hasil produk yang dirakam.
Eja nombor atau singkatan jika suara membacanya salah. Uji nama jenama dan individu sebenar sebelum skrip penuh. Suara yang baik dalam bahasa Inggeris biasa mungkin masih perlukan bantuan dengan nama produk atau campuran bahasa.
2. Jana dan luluskan suara
Pilih suara sesuai dengan khalayak dan bahasa. Dengar tanpa melihat wajah. Semak sebutan, rentak, emosi dan perkataan terakhir, kemudian ubah teks atau tetapan disokong.
Simpan audio diluluskan sebelum animasi. Jika platform menyatukan peringkat dan menawarkan pradengar, gunakannya. Jika tidak, mulakan pendek supaya pembetulan kecil tidak memerlukan video panjang dijana semula.
3. Animasikan potret dan semak eksport
Muat naik audio diluluskan ke aliran foto bercakap atau gunakan laluan skrip disokong. Semak model, tempoh disebut harga, pangkasan dan syarat eksport. Catat tetapan dengan fail sumber.
Tonton pada kelajuan biasa. Periksa frasa pertama, jeda dan penutupan terakhir, kemudian seluruh muka serta leher. Jika identiti berubah, cuba sumber lebih jelas atau laluan lain, bukan terus menyalahkan suara.
Baiki skrip pemasaran sebelum menjana
Bandingkan contoh asli berikut:
| Draf | Versi pertuturan | Mengapa perubahan membantu |
|---|---|---|
| Platform kami membolehkan pengoptimuman aliran kerja menyeluruh. | Letakkan tugas pasukan seterusnya dalam senarai bersama. | Memberi tindakan konkrit |
| Sila navigasi ke bahagian tetapan untuk meneruskan. | Buka tetapan. Kemudian pilih bahasa. | Mewujudkan sempadan frasa jelas |
| Jimat 20% sebelum 10/31. | Jimat dua puluh peratus sebelum tiga puluh satu Oktober. | Mengurangkan kekaburan bacaan nombor |
Ini contoh penulisan, bukan dakwaan semua suara memerlukan nombor dieja. Pradengar output sebenar dan simpan versi yang menyampaikan maksud dengan jelas serta semula jadi.
Untuk pengenalan ringkas, gunakan tiga bahagian: siapa dibantu, tugas segera dan tindakan seterusnya. Contoh: “Mengurus kelas kecil? Satukan senarai pelajaran di satu tempat. Buka templat dan tambah aktiviti pertama.” Pendekkan segmen potret supaya demonstrasi produk menerangkan butiran.
Jika sudah ada rakaman siap, langkau TTS dan gunakan fail dalam alat foto bercakap. Tujuannya meluluskan suara, bukan memaksa setiap projek melalui sintesis.
Bagaimana menambah jeda?
Mulakan dengan tanda baca biasa. Noktah lazimnya memberi sempadan lebih kuat daripada koma, tetapi penyampaian bergantung pada model. Ayat pendek lebih mudah disunting daripada baris panjang penuh tanda jeda.
Sesetengah enjin menyokong jeda SSML, tag audio atau kawalan lain. Jangan anggap sintaks boleh saling ganti. Arahan satu model mungkin diabaikan atau dibaca kuat oleh model lain.
Dokumentasi TTS ElevenLabs membezakan model dan keupayaan. Ikuti dokumentasi model tepat sebelum menambah tag. Jika ada kawalan jeda khusus, uji pradengar pendek dan simpan hasil diterima.
Contohnya teks biasa “Buka tetapan. Kemudian pilih bahasa.” ialah permulaan yang mudah digunakan merentas alat. Tag <break time="500ms"/> hanya sesuai jika enjin menyokong sintaks SSML itu dengan jelas. Ia meminta jeda setengah saat, bukan arahan sejagat.
Laluan alat manakah patut digunakan?
| Keadaan awal | Laluan untuk diteliti | Batas utama |
|---|---|---|
| Skrip dan potret tanpa rakaman | Foto bercakap dengan teks bersepadu | Pradengar suara dan semak model |
| Audio TTS luar yang diluluskan | Muat naik audio ke alat foto | Kekalkan masa tepat dan hak suara |
| Perlu suara peribadi dikenali | Klon berizin dan animasi foto | Dapatkan persetujuan suara dan rupa berasingan |
| Perlu beberapa bahasa | Skrip disemak penutur asli dan suara mengikut bahasa | Ketersediaan tidak bermakna kualiti sama |
Halaman Studio D-ID menerangkan teks, audio dan imej pegun untuk video avatar. Halaman penyegerakan HeyGen merangkumi skrip ditaip serta avatar foto bersama aliran rakaman. Panduan imej Sync menerangkan pilihan skrip dan suara sync-3.
Penerangan rasmi memberi sebab meneliti laluan, bukan bukti perbandingan realisme. Pendedahan: LipSyncX menerbitkan artikel dan menawarkan aliran foto bercakap komersial. Tiada dakwaan kedudukan kualiti bebas dengan input sama.
Apakah maksud angka bahasa?
Sokongan adalah khusus model. Dokumen ElevenLabs yang disemak 25 Oktober 2026 menyenaraikan Flash v2.5 dengan 32 bahasa dan Multilingual v2 dengan 29; keluarga baharu mempunyai jumlah lain. Rekod model tepat, bukan memberi semua suara liputan iklan terbesar.
Platform video juga demikian. Bahasa untuk audio muat naik, terjemahan atau suara sedia ada mungkin tiada dalam setiap mod klon atau avatar. Sahkan gabungan dalam aliran sebenar.
Untuk kandungan berbilang bahasa, minta penutur asli meluluskan teks dan mendengar audio. Sertakan nama, tarikh dan istilah teknikal dalam percubaan. Mulut munasabah tidak membuktikan terjemahan tepat.
Asingkan izin suara dan rupa
Seseorang boleh membenarkan paparan fotonya tanpa membenarkan kata baharu dikaitkan dengannya. Pelakon suara boleh melesenkan rakaman tanpa klon. Catat tujuan, pengedaran, tempoh dan skop komersial sebelum menjana untuk pelanggan.
Bagi klon dikenali, dapatkan izin jelas individu atau pemegang hak berkuasa. Simpan persetujuan bersama sumber dan hubungan bagi pembetulan atau penarikan. Jangan bayangkan ucapan dijana ialah rakaman sebenar.
Semak juga terma dan amalan data alat. Alat pelayar biasanya memuat naik fail; peraturan pemadaman atau latihan boleh berbeza mengikut pelan. Untuk kerja sensitif atau berbayar, baca keselamatan muat naik wajah, latihan dan pengekalan, kegunaan komersial.
Baiki peringkat yang gagal
Jika nama produk salah, sunting atau jana semula suara. Jika jelas tetapi terlalu pantas, pendekkan skrip atau gunakan kawalan rentak disokong. Jika wajah berubah atau gigi berkelip, semak imej dan model visual.
Jika mulut bergerak semasa jeda, simpan kod masa dan semak pilihan pemasaan atau model. Jika kata terakhir terpotong, bandingkan tempoh audio, klip dihantar dan eksport. Jangan ubah banyak pemboleh ubah serentak kerana tidak diketahui pembetulan mana membantu.
Ujian pendek memudahkan pengurusan. Simpan percubaan ditolak sebagai bukti serta rakaman dan tetapan diterima. Untuk projek besar, senarai penjana membantu mencari laluan lain tanpa menulis semua semula.
Soalan lazim
Bolehkah foto bercakap melalui teks tanpa mikrofon?
Ya. Jana suara sintetik berlesen daripada skrip, kemudian animasikan foto dengan audio atau laluan teks bersepadu.
Perlukah mengklon suara sendiri?
Tidak. Suara sedia ada atau direka boleh digunakan. Klon pilihan dan memerlukan izin serta sokongan tersendiri.
Bolehkah SSML dimasukkan ke semua kotak teks?
Tidak. Gunakan SSML atau tag hanya apabila enjin dan model tepat mendokumenkan sokongan. Jika tidak, mula dengan teks dan tanda baca biasa.
Adakah terjemahan mengekalkan pemasaan?
Tidak semestinya. Bahasa berbeza panjang dan rentak. Luluskan adaptasi mudah dituturkan dan ukur audio sebelum menjana wajah.
Adakah wajah realistik menjadikan suara lebih semula jadi?
Ia boleh mempengaruhi tanggapan tetapi tidak membaiki sebutan atau rentak. Dengar audio sahaja sebelum menilai animasi.
Luluskan dua ayat sebelum menganimasi
Tulis mesej pendek dengan nama dan nombor sebenar diperlukan khalayak. Bawa ke alat foto bercakap, pradengar suara dan jana potret pendek hanya selepas audio menyebut maksud tepat anda.
Log perubahan
- 2026-10-25: Laluan rasmi teks, audio dan imej serta bahasa TTS khusus model disemak. Ditambah contoh pertuturan, panduan SSML bersyarat dan semakan izin suara serta rupa berasingan.