
テキスト読み上げで写真を話させる:マイクは不要
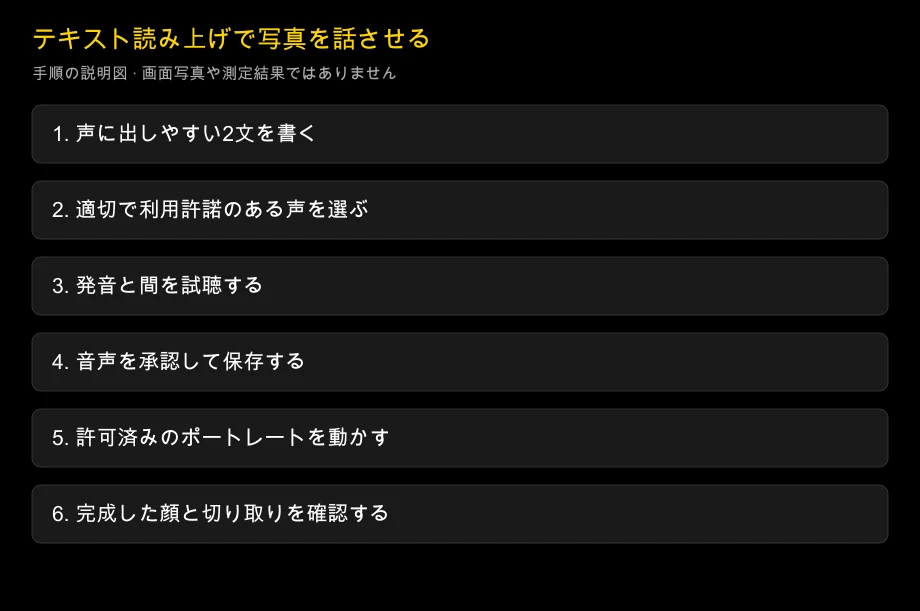
はい。自分で録音しなくても、テキスト読み上げで写真を話させられます。原稿を書き、利用許諾のある音声を生成して確認し、その音声を画像から話す動画を作るツールに渡します。3段階をまとめたサービスもありますが、顔の生成前に音声を確認すると不要な再生成を防げます。
確認日:2026-10-25。 D-ID、HeyGen、Sync、ElevenLabs の公式説明を確認したガイドです。対応言語と間の調整は選んだ音声モデルによって異なり、企業全体の宣伝上の数字から推測すべきではありません。
確実な順番は原稿、音声、顔です。口が正しく同期しても発音は間違うことがあるので、アニメーションを評価する前に音声を承認します。
始める前に必要なもの
使用許可のあるポートレート、短い原稿、目的の用途に使える声を用意します。口が隠れていない鮮明な正面顔が最初のテストに適しています。顎全体と、最終的な切り取りに必要な周囲を残してください。
通常のテキスト読み上げにマイクは不要です。音声クローンは任意で、追加の同意が必要になります。特定の人物を再現しなければ、既成または設計した声で十分な場合があります。
元画像、テキスト、完成音声、設定を一緒に保管します。後で文言を変えたら、古い音声を上書きせず別バージョンにします。新しい字幕と古い録音の組み合わせを防ぎやすくなります。
3段階で写真を話させる
1. 読む文章ではなく聞く文章を書く
1文に1つの内容を置き、主な行動を早く伝えます。合成音声が読む場合も声に出してみてください。自分の表現を理解するために止まるなら、聞き手も同じ可能性があります。
最初の原稿は短い2文ほどが便利です。例:「ワークスペースへようこそ。チェックリストを開き、最初のタスクを選んでください。」これはオリジナルの原稿例で、製品出力の録音ではありません。
数字や略語を読み間違えるなら、読み方を具体的に書きます。全文を書く前に実際のブランド名や人名を試してください。普通の英語が上手な声でも、商品名や複数言語の混ざった語句には調整が必要な場合があります。
2. 音声を生成して承認する
聞き手と言語に合う声を選びます。顔を見ずに聞き、発音、速さ、感情、最後の語を確認してから、テキストや対応する音声設定を変更します。
画像を動かす前に承認済み音声を保存します。段階を統合したサービスに音声プレビューがあれば使ってください。なければ短い試作から始め、小さな文言修正で長い動画を作り直さずに済むようにします。
3. ポートレートを動かし書き出しを確認する
承認済み音声を話す写真の機能にアップロードするか、対応する原稿入力を使います。選択モデル、見積もり時間、切り取り、書き出し条件を確認し、元ファイルと設定を記録します。
通常速度で結果を見ます。最初の語句、間、最後の口の閉じ方に続き、顔全体と首を確認します。顔が別人のように変わるなら、声のせいと決めず、鮮明な画像や別の手順を試します。
生成前に販促原稿を改善する
次のオリジナル例を比べてください。
| 初稿 | 話すための文 | 変更の効果 |
|---|---|---|
| 当社のプラットフォームは包括的な業務最適化を実現します。 | チームの次の仕事を、共有チェックリストにまとめましょう。 | 聞き手に具体的な行動を示す |
| 続けるには設定セクションへ移動してください。 | 設定を開きます。次に言語を選びます。 | 明確な文の区切りを作る |
| 10/31まで20%お得。 | 十月三十一日まで、二十パーセントお得です。 | 数字の読み方の曖昧さを減らす |
これは文章例であり、すべての声で数字を綴る必要があるという主張ではありません。実際の出力を試聴し、意図を明確かつ自然に伝える版を残します。
短い商品紹介は、誰を助けるか、今する作業、次の行動の3部構成が使えます。例:「少人数クラスを担当していますか。授業のチェックリストを1か所にまとめましょう。テンプレートを開き、最初の活動を加えてください。」詳しい説明は商品実演が担えるよう、顔の場面を短くします。
完成録音がすでにあれば TTS を省き、そのファイルを話す写真ツールで使います。目的は音声を承認することで、すべての案件を音声合成に通すことではありません。
間はどう追加しますか?
まず普通の句読点を使います。句点は読点より強い区切りを促すことが多いものの、具体的な読み方はモデル依存です。間の記号を詰めた長文より、短い文のほうが修正しやすくなります。
SSML の間、音声タグなどに対応するエンジンもあります。構文を互換だと思わないでください。あるモデル向けの命令が別モデルでは無視されたり、そのまま読み上げられたりします。
ElevenLabs の TTS 文書は音声モデルと機能を区別しています。タグを加える前に該当モデルの文書を読み、専用の間設定があれば短く試聴して承認した結果を保管します。
例えば「設定を開きます。次に言語を選びます。」という普通のテキストは汎用的な出発点です。<break time="500ms"/> のようなタグは、その SSML 構文を明示的にサポートするエンジンでのみ使います。これは半秒の間を要求する例で、全エンジン共通の命令ではありません。
どのツールの手順を選ぶべきですか?
| 出発点 | 調べる手順 | 主な注意点 |
|---|---|---|
| 原稿と写真があり録音はない | テキスト入力統合型の話す写真 | 音声を試聴しモデルを確認 |
| 承認済みの外部 TTS 音声 | 写真ツールに音声をアップロード | 正確なタイミングと声の権利を維持 |
| 本人と分かる声が必要 | 許可済みクローンと写真アニメーション | 声と肖像の同意を別々に取得 |
| 複数言語が必要 | 母語話者確認の原稿と言語別の声 | 対応しているだけで同じ品質と推定しない |
D-ID の Studio ページはアバター動画のテキスト、音声、静止画入力を説明しています。HeyGen のリップシンクページは映像の手順に加え、原稿入力や写真アバターを説明しています。Sync の画像ガイドは sync-3 の原稿と音声の選択肢を説明しています。
公式説明は手順を調べる根拠になりますが、写実性の比較証拠ではありません。開示事項: LipSyncX がこの記事を公開し、商用の話す写真の手順を提供しています。同一入力による独立した品質順位は主張していません。
対応言語数は何を意味しますか?
言語対応はモデルごとです。2026年10月25日に確認した ElevenLabs の文書では Flash v2.5 が32言語、Multilingual v2 が29言語で、新しいモデル群は別の総数を示します。宣伝上の最大数をどの声にも当てはめず、正確なモデルを記録してください。
動画サービスも同じです。アップロード音声、翻訳、既成の声で利用できる言語が、すべてのクローンやアバターモードで利用できるとは限りません。実際の手順で必要な組み合わせを確認します。
多言語の場合、母語話者に文章を確認してもらい、生成音声も聞いてもらいます。試作に人名、日付、専門用語を入れてください。口がそれらしく動いても翻訳の正確さは分かりません。
声と肖像の許可を分けて扱う
写真の表示には同意していても、新しい発言を自分に帰属させることには同意していない場合があります。声優も録音を許諾していてクローンは許可していない場合があります。顧客向け生成前に用途、配信先、期間、商用範囲を記録します。
本人と分かる声のクローンには、本人または正当な権利者から明確な許可を得ます。同意、元素材、更正や撤回の連絡先を一緒に保管し、生成発言が実際の録音だったとほのめかさないでください。
ツールの規約やデータ運用も確認します。ブラウザツールは通常ファイルをアップロードして処理し、削除や学習の規則はプランで異なる場合があります。機微な案件や有償案件には顔のアップロード安全ガイド、学習と保持のガイド、商用利用ガイドを参照してください。
失敗した段階を直す
商品名が間違っていれば音声を修正または再生成します。明瞭でも速すぎるなら原稿を短くするか対応する速度調整を使います。顔が変化したり歯がちらついたりするなら画像と映像モデルを確認します。
間でも口が動くなら時刻を記録し、タイミングやモデル設定を調べます。最後の語が切れるなら音声、送信区間、書き出しの長さを比較します。複数の要素を一度に変えると、どの修正が効いたか分からなくなります。
短い試作なら管理しやすくなります。不採用の試行も証拠として残し、承認した録音と画像設定を保存します。大きな案件では生成ツール候補リストを使い、原稿作りからやり直さず適した別手順を探せます。
よくある質問
マイクなしでテキスト読み上げから写真を話させられますか?
はい。原稿から利用許諾のある合成音声を作り、その音声か統合テキスト入力で写真を動かします。
自分の声をクローンする必要がありますか?
いいえ。既成または設計した声でも使えます。クローンは任意で、別の許可と機能対応が必要です。
どのテキスト欄にも SSML を入れられますか?
いいえ。エンジンとモデルが明記している場合だけ SSML や音声タグを使い、それ以外は普通の文章と句読点で始めます。
原稿を翻訳しても同じ時間になりますか?
必ずしもそうではありません。言語で語句の長さや速さが異なります。顔の生成前に話しやすい訳を承認し、実際の音声時間を測ります。
写実的な顔なら声も自然に聞こえますか?
印象は変わり得ますが、発音や速さは直りません。アニメーションを評価する前に音声だけで聞いてください。
動かす前に2文を承認する
視聴者に必要な実際の名前や数字を含む短い文を書きます。話す写真ツールに渡して音声を試聴し、意図どおりに読まれてから短いポートレート動画を生成します。
更新履歴
- 2026-10-25: 公式の文章・音声・画像手順とモデル別 TTS 言語情報を確認。話す原稿の例、条件付き SSML の案内、声と肖像を分けた許可確認を追加しました。