
Mówiące zdjęcie z tekstu na mowę: bez mikrofonu
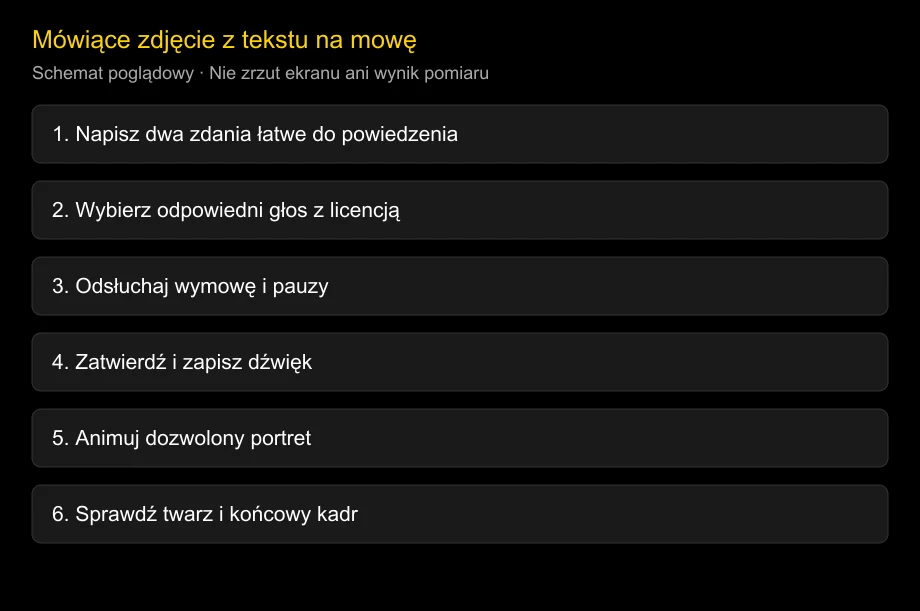
Tak, możesz stworzyć mówiące zdjęcie z tekstu na mowę bez własnego nagrania. Napisz tekst, wygeneruj i zatwierdź licencjonowany głos, a potem użyj dźwięku w narzędziu tworzącym mówiący film z obrazu. Niektóre platformy łączą trzy etapy, ale sprawdzenie głosu przed twarzą zapobiega zbędnym powtórkom.
Sprawdzono: 2026-10-25. Poradnik analizuje oficjalne opisy D-ID, HeyGen, Sync i ElevenLabs. Języki i pauzy zależą od modelu głosu; nie można ich wywnioskować z ogólnego hasła firmy.
Pewna kolejność to tekst, głos, twarz. Zsynchronizowane usta nadal mogą źle wymawiać, więc zatwierdź dźwięk przed oceną animacji.
Co przygotować przed rozpoczęciem
Przygotuj dozwolony portret, krótki tekst i głos dopuszczony do planowanego celu. Wyraźna twarz z przodu, z odsłoniętymi ustami, nadaje się na pierwszy test. Zachowaj cały podbródek i margines na końcowe kadrowanie.
Zwykła synteza mowy nie wymaga mikrofonu. Klonowanie jest opcjonalne i wymaga dodatkowych zgód. Głos gotowy lub zaprojektowany może wystarczyć bez odtwarzania konkretnej osoby.
Zachowaj razem obraz źródłowy, tekst, dźwięk i ustawienia. Po zmianie słów zapisz nową wersję audio, zamiast nadpisywać starą. Łatwiej unikniesz nowych napisów ze starym nagraniem.
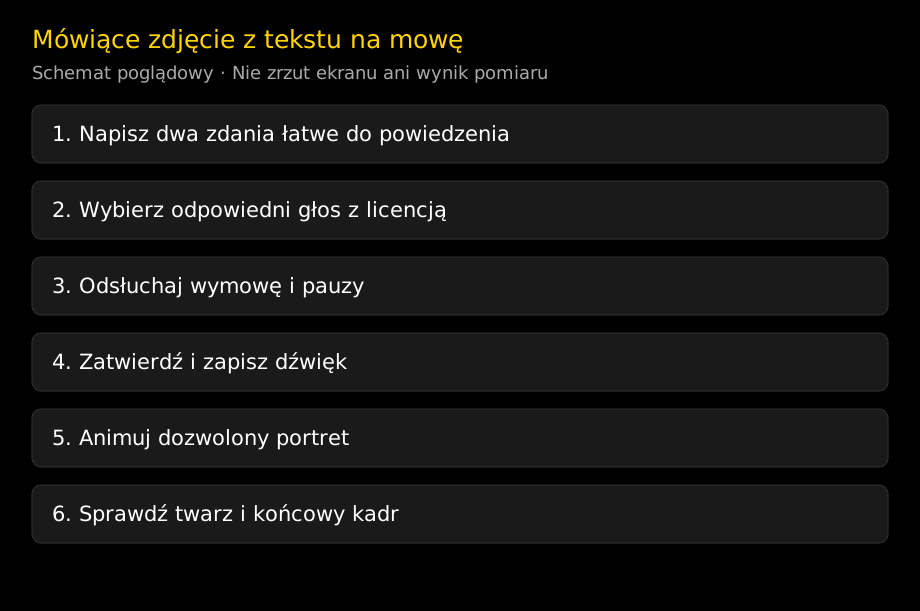
Stwórz mówiące zdjęcie w trzech etapach
1. Pisz do słuchania, nie do czytania
Umieść jedną myśl w zdaniu i główną czynność na początku. Przeczytaj na głos, nawet jeśli przemówi syntezator. Jeśli musisz się zatrzymać, by zrozumieć własne sformułowanie, słuchacz zapewne też.
Dobry początek to dwa krótkie zdania. Na przykład: „Witaj w obszarze roboczym. Otwórz listę i wybierz pierwsze zadanie”. To oryginalny przykład tekstu, nie nagrany wynik produktu.
Rozpisz liczby lub skróty, jeśli głos czyta je źle. Przetestuj prawdziwe nazwy marek i osób przed całym tekstem. Głos dobrze czytający zwykły angielski może potrzebować pomocy z nazwą produktu lub mieszaniną języków.
2. Wygeneruj i zatwierdź głos
Wybierz głos pasujący do odbiorcy i języka. Słuchaj bez patrzenia na twarz. Sprawdź wymowę, tempo, emocje i ostatnie słowo, a potem zmień tekst lub obsługiwane ustawienia.
Zapisz zatwierdzony dźwięk przed animowaniem. Jeśli zintegrowana platforma oferuje podgląd głosu, użyj go. Jeśli nie, zacznij krótko, by mała poprawka nie wymagała ponownego tworzenia długiego filmu.
3. Animuj portret i sprawdź eksport
Prześlij zatwierdzone audio do procesu mówiącego zdjęcia albo użyj obsługiwanego tekstu. Sprawdź model, wyceniony czas, kadr i warunki eksportu. Zapisz ustawienia ze źródłami.
Oglądaj w normalnym tempie. Sprawdź pierwszą frazę, pauzy i ostatnie zamknięcie ust, potem całą twarz i szyję. Jeśli tożsamość się zmienia, spróbuj wyraźniejszego źródła lub innego procesu, zamiast obwiniać głos.
Popraw tekst marketingowy przed generowaniem
Porównaj oryginalne przykłady:
| Szkic | Wersja mówiona | Korzyść ze zmiany |
|---|---|---|
| Nasza platforma umożliwia kompleksową optymalizację procesów. | Umieść następne zadanie zespołu na wspólnej liście. | Daje konkretną czynność |
| Przejdź do sekcji ustawień, aby kontynuować. | Otwórz ustawienia. Następnie wybierz język. | Tworzy jasne rozdzielenie fraz |
| Oszczędź 20% przed 10/31. | Oszczędź dwadzieścia procent przed trzydziestym pierwszym października. | Zmniejsza niejednoznaczne czytanie liczb |
To przykłady pisania, nie wymóg rozpisywania liczb dla każdego głosu. Odsłuchaj rzeczywisty wynik i zachowaj wersję jasno oraz naturalnie przekazującą właściwy sens.
Krótka prezentacja może mieć trzy części: komu pomaga, zadanie teraz i następny krok. Na przykład: „Prowadzisz małą klasę? Zbierz listę lekcji w jednym miejscu. Otwórz szablon i dodaj pierwszą aktywność”. Skróć portret, by szczegóły pokazała demonstracja produktu.
Jeśli masz gotowe nagranie, pomiń TTS i użyj pliku w narzędziu mówiących zdjęć. Chodzi o zatwierdzenie głosu, nie narzucenie syntezy każdemu projektowi.
Jak dodać pauzy?
Zacznij od zwykłej interpunkcji. Kropka zwykle daje silniejszą granicę niż przecinek, choć wykonanie zależy od modelu. Krótkie zdania poprawia się łatwiej niż długą linię pełną znaczników pauz.
Niektóre silniki obsługują przerwy SSML, znaczniki audio lub inne kontrolki. Nie zakładaj wymienności składni. Polecenie jednego modelu może zostać zignorowane lub odczytane przez drugi.
Dokumentacja TTS ElevenLabs rozróżnia modele i możliwości. Przed dodaniem tagów przeczytaj opis konkretnego modelu. Jeśli obsługuje sterowanie pauzą, sprawdź krótki odsłuch i zachowaj zaakceptowany wynik.
Na przykład zwykły tekst „Otwórz ustawienia. Następnie wybierz język” jest przenośnym początkiem. Tag <break time="500ms"/> nadaje się tylko do silnika jawnie obsługującego taką składnię SSML. Prosi o pół sekundy pauzy, nie jest uniwersalnym poleceniem.
Którą ścieżkę narzędzi wybrać?
| Początek | Ścieżka do sprawdzenia | Główna granica |
|---|---|---|
| Tekst i portret, bez nagrania | Zintegrowany tekst do mówiącego zdjęcia | Odsłuchaj głos i sprawdź model |
| Zatwierdzone zewnętrzne audio TTS | Przesłanie audio do narzędzia zdjęć | Zachowaj dokładny czas i prawa do głosu |
| Potrzebny rozpoznawalny głos osoby | Dozwolony klon i animacja zdjęcia | Osobne zgody na głos i wizerunek |
| Potrzebne różne języki | Teksty sprawdzone przez rodzimych użytkowników i właściwe głosy | Dostępność nie oznacza równej jakości |
Strona Studio D-ID opisuje tekst, audio i zdjęcia do filmów z awatarami. Strona synchronizacji HeyGen obejmuje wpisany tekst i awatary zdjęciowe obok istniejących filmów. Poradnik obrazów Sync opisuje tekst i głos w sync-3.
Oficjalne opisy uzasadniają zbadanie ścieżki, ale nie porównują realizmu. Ujawnienie: LipSyncX publikuje artykuł i oferuje komercyjny proces mówiących zdjęć. Nie deklarujemy niezależnego rankingu na identycznych danych.
Co oznaczają liczby języków?
Wsparcie jest zależne od modelu. Dokumentacja ElevenLabs sprawdzona 25 października 2026 r. podaje 32 języki dla Flash v2.5 i 29 dla Multilingual v2; nowsze rodziny mają inne sumy. Zapisuj dokładny model, zamiast przypisywać każdemu głosowi największy reklamowany zakres.
Tak samo z platformami wideo. Język dostępny dla przesłanego audio, tłumaczenia lub gotowej barwy może być niedostępny w każdym klonie i awatarze. Sprawdź potrzebną kombinację w rzeczywistym procesie.
W treściach wielojęzycznych poproś rodzimego użytkownika języka o zatwierdzenie tekstu i odsłuchanie audio. W próbie uwzględnij nazwy, daty i terminy techniczne. Wiarygodne usta nie dowodzą poprawności tłumaczenia.
Oddziel pozwolenia na głos i wizerunek
Ktoś może zgodzić się na pokazanie zdjęcia, lecz nie na przypisanie nowych wypowiedzi. Aktor może licencjonować nagranie bez pozwolenia na klon. Zapisz cel, dystrybucję, okres i zakres komercyjny przed pracą dla klienta.
Dla rozpoznawalnego klonu uzyskaj wyraźną zgodę osoby lub uprawnionego właściciela praw. Trzymaj ją ze źródłami i kontaktem do korekt lub wycofania. Nie sugeruj, że wygenerowana wypowiedź była prawdziwym nagraniem.
Sprawdź także regulamin i dane. Narzędzie przeglądarkowe zwykle przesyła pliki, a zasady usuwania i treningu mogą różnić się według planu. Dla wrażliwej lub płatnej pracy przeczytaj poradniki o bezpieczeństwie twarzy, treningu i retencji i użytku komercyjnym.
Napraw etap, który zawiódł
Jeśli nazwa produktu jest błędna, popraw lub wygeneruj głos ponownie. Jeśli jest wyraźny, ale zbyt szybki, skróć tekst lub użyj obsługiwanej kontroli tempa. Gdy twarz się zmienia lub zęby migoczą, sprawdź obraz i model wizualny.
Jeśli usta ruszają się w pauzie, zapisz czas i sprawdź ustawienia czasu lub modelu. Jeśli ostatnie słowo jest ucięte, porównaj długość audio, wysłanego odcinka i eksportu. Nie zmieniaj kilku zmiennych naraz, bo nie ustalisz, co pomogło.
Krótka próba ułatwia zarządzanie. Zachowaj odrzucone próby jako dowody oraz zatwierdzoną ścieżkę i ustawienia. W większych projektach lista generatorów pomaga znaleźć inną drogę bez pisania wszystkiego od nowa.
Najczęstsze pytania
Czy można zrobić mówiące zdjęcie z tekstu bez mikrofonu?
Tak. Wygeneruj z tekstu licencjonowany głos syntetyczny i animuj zdjęcie dźwiękiem lub zintegrowanym tekstem.
Czy muszę klonować swój głos?
Nie. Gotowe lub zaprojektowane głosy mogą wystarczyć. Klonowanie jest opcjonalne i wymaga osobnej zgody i funkcji.
Czy SSML można wkleić do każdego pola?
Nie. Używaj SSML i tagów tylko przy dokumentowanym wsparciu konkretnego silnika i modelu. W przeciwnym razie zacznij od tekstu i interpunkcji.
Czy tłumaczenie zachowa czas?
Niekoniecznie. Języki mają różną długość i rytm. Zatwierdź wersję łatwą do powiedzenia i zmierz audio przed tworzeniem twarzy.
Czy realistyczna twarz poprawia naturalność głosu?
Może wpłynąć na wrażenie, ale nie naprawia wymowy ani tempa. Posłuchaj audio osobno przed animacją.
Zatwierdź dwa zdania przed animacją
Napisz krótką wiadomość z prawdziwymi nazwami i liczbami potrzebnymi odbiorcom. Otwórz ją w narzędziu mówiących zdjęć, odsłuchaj głos i wygeneruj portret dopiero po potwierdzeniu właściwej treści.
Historia zmian
- 2026-10-25: Sprawdzono oficjalne ścieżki tekstu, dźwięku i obrazu oraz języki TTS według modelu. Dodano przykłady mówione, warunkowe wskazówki SSML i osobne zgody głosu i wizerunku.