
Membuat foto berbicara dari teks ke suara: tanpa mikrofon
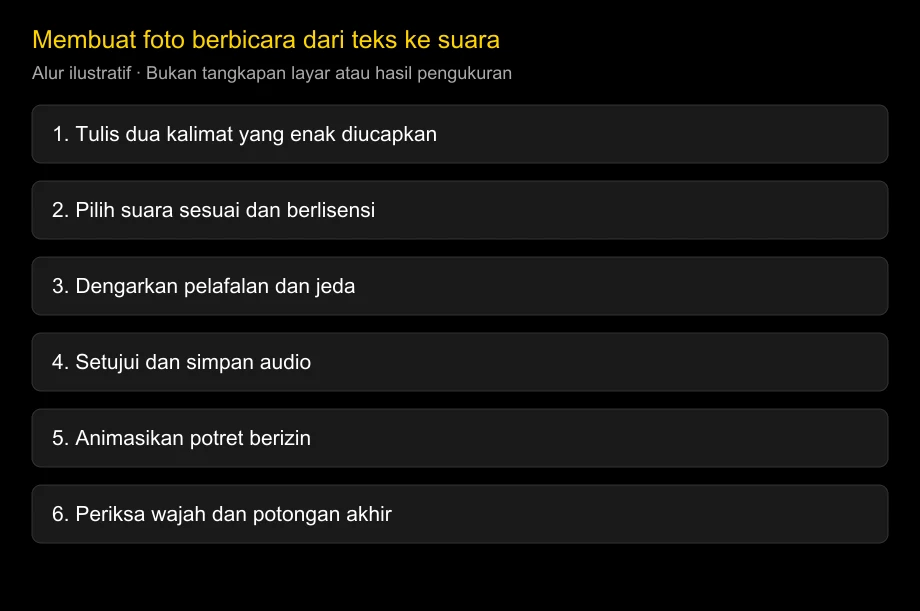
Ya, Anda bisa membuat foto berbicara dari teks ke suara tanpa merekam diri. Tulis naskah, buat dan setujui suara berlisensi, lalu gunakan audionya dalam alat gambar menjadi video berbicara. Beberapa platform menyatukan tiga tahap, tetapi memeriksa suara sebelum wajah mencegah pembuatan ulang yang tidak perlu.
Diperiksa: 2026-10-25. Panduan meninjau keterangan resmi D-ID, HeyGen, Sync, dan ElevenLabs. Dukungan bahasa dan jeda bergantung pada model suara, bukan judul promosi umum perusahaan.
Urutan yang andal adalah naskah, suara, lalu wajah. Mulut tersinkron pun bisa salah melafalkan, jadi setujui audio sebelum menilai animasi.
Yang dibutuhkan sebelum mulai
Siapkan potret berizin, naskah singkat, dan suara yang boleh digunakan untuk tujuan Anda. Wajah depan jelas dengan mulut bebas penghalang cocok untuk tes awal. Pertahankan seluruh dagu dan ruang untuk pemotongan akhir.
Teks ke suara biasa tidak memerlukan mikrofon. Kloning bersifat opsional dan menambah kebutuhan persetujuan. Suara stok atau rancangan dapat sesuai jika tidak perlu meniru orang tertentu.
Simpan gambar sumber, teks, audio akhir, dan pengaturan bersama. Jika kata berubah, buat versi audio baru alih-alih menimpa yang lama. Ini mencegah takarir baru dipasangkan dengan rekaman lama.
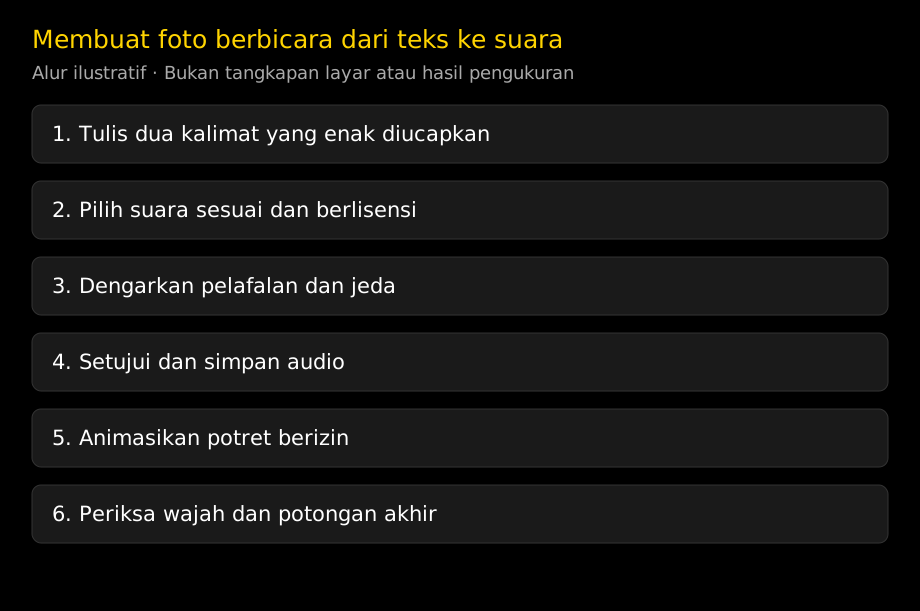
Buat foto berbicara dalam tiga tahap
1. Tulis untuk didengar, bukan dibaca
Satu ide per kalimat, dengan tindakan utama di awal. Bacakan keras meski suara sintetis yang akan membawakan. Jika Anda perlu berhenti untuk memahami tulisan sendiri, pendengar mungkin juga demikian.
Dua kalimat pendek cocok sebagai naskah awal. Contoh: “Selamat datang di ruang kerja. Buka daftar periksa, lalu pilih tugas pertama.” Ini contoh orisinal, bukan hasil produk yang direkam.
Tuliskan angka atau singkatan lengkap jika salah dibaca. Uji nama merek dan orang sebenarnya sebelum naskah lengkap. Suara yang bagus dalam bahasa Inggris biasa bisa perlu bantuan untuk nama produk atau campuran bahasa.
2. Buat dan setujui suara
Pilih suara sesuai audiens dan bahasa. Dengarkan tanpa melihat wajah. Periksa pelafalan, tempo, emosi, dan kata terakhir, kemudian ubah teks atau pengaturan yang didukung.
Simpan audio disetujui sebelum animasi. Jika platform menggabungkan tahap dan menyediakan pratinjau suara, gunakan. Jika tidak, mulai pendek agar perubahan kecil tak perlu membuat ulang video panjang.
3. Animasikan potret dan tinjau ekspor
Unggah audio disetujui ke alur foto berbicara atau gunakan input naskah yang didukung. Periksa model, durasi penawaran, potongan, dan syarat ekspor. Catat pengaturan dengan sumber.
Tonton pada kecepatan normal. Periksa frasa awal, jeda, penutupan terakhir, lalu seluruh wajah dan leher. Jika identitas berubah, coba sumber lebih jelas atau cara lain, bukan langsung menyalahkan suara.
Perbaiki naskah pemasaran sebelum membuat
Bandingkan contoh orisinal berikut:
| Draf | Versi lisan | Manfaat perbaikan |
|---|---|---|
| Platform kami memungkinkan optimasi alur kerja menyeluruh. | Taruh tugas tim berikutnya dalam satu daftar bersama. | Memberi tindakan konkret |
| Silakan navigasi ke bagian pengaturan untuk melanjutkan. | Buka pengaturan. Lalu pilih bahasa. | Membuat batas frasa jelas |
| Hemat 20% sebelum 10/31. | Hemat dua puluh persen sebelum tiga puluh satu Oktober. | Mengurangi ambigu pembacaan angka |
Ini contoh menulis, bukan klaim setiap suara perlu angka dieja. Dengarkan hasil nyata dan simpan versi yang menyampaikan maksud dengan jelas serta alami.
Untuk perkenalan produk singkat, gunakan tiga bagian: siapa dibantu, tugas langsung, tindakan berikutnya. Misalnya: “Mengelola kelas kecil? Kumpulkan daftar pelajaran di satu tempat. Buka templat dan tambahkan kegiatan pertama.” Buat bagian potret singkat agar demo produk menjelaskan detail.
Jika rekaman sudah jadi, lewati TTS dan gunakan berkas di alat foto berbicara. Tujuannya menyetujui suara, bukan memaksa setiap proyek melalui sintesis.
Bagaimana menambahkan jeda?
Mulai dari tanda baca biasa. Titik biasanya memberi batas lebih kuat daripada koma, meski penyampaian bergantung model. Kalimat pendek lebih mudah direvisi daripada satu baris panjang penuh tanda jeda.
Sebagian mesin mendukung jeda SSML, tag audio, atau kontrol lain. Jangan anggap sintaks dapat dipertukarkan. Perintah untuk satu model bisa diabaikan atau dibaca keras oleh model lain.
Dokumentasi TTS ElevenLabs membedakan model dan kemampuan. Ikuti dokumen model tepat sebelum memberi tag. Jika ada kontrol jeda khusus, uji pratinjau singkat dan simpan hasil yang diterima.
Misalnya, teks biasa “Buka pengaturan. Lalu pilih bahasa.” adalah awal yang mudah dipindahkan. Tag seperti <break time="500ms"/> hanya tepat pada mesin yang jelas mendukung sintaks SSML itu. Contoh meminta jeda setengah detik, bukan perintah universal.
Jalur alat mana yang dipakai?
| Kondisi awal | Jalur yang diteliti | Batas utama |
|---|---|---|
| Naskah dan potret, belum ada rekaman | Foto berbicara dengan teks terintegrasi | Dengarkan suara dan periksa model |
| Audio TTS eksternal disetujui | Unggah audio ke alat foto | Pertahankan waktu tepat dan hak suara |
| Perlu suara pribadi dikenali | Klon berizin dengan animasi foto | Dapatkan persetujuan suara dan rupa terpisah |
| Perlu beberapa bahasa | Naskah diperiksa penutur asli dan suara per bahasa | Ketersediaan tidak membuktikan kualitas sama |
Halaman Studio D-ID menjelaskan teks, audio, dan gambar diam untuk video avatar. Halaman sinkronisasi HeyGen memuat naskah ketikan dan avatar foto bersama alur rekaman. Panduan gambar Sync menjelaskan pilihan naskah dan suara sync-3.
Penjelasan resmi ini menjadi alasan menyelidiki jalur, bukan bukti perbandingan realisme. Pengungkapan: LipSyncX menerbitkan artikel dan menawarkan alur foto berbicara komersial. Tidak ada klaim peringkat kualitas independen dengan masukan sama.
Apa arti jumlah bahasa?
Dukungan bersifat spesifik model. Dokumen ElevenLabs yang diperiksa 25 Oktober 2026 mencantumkan Flash v2.5 dengan 32 bahasa dan Multilingual v2 dengan 29; keluarga baru punya jumlah lain. Catat model tepat, bukan memberikan cakupan iklan terbesar pada semua suara.
Hal sama berlaku di platform video. Bahasa yang tersedia untuk audio unggahan, terjemahan, atau suara stok belum tentu ada pada setiap mode klon atau avatar. Periksa kombinasi dalam alur sebenarnya.
Untuk konten multibahasa, minta penutur asli menyetujui teks dan mendengarkan audio. Masukkan nama, tanggal, dan istilah teknis dalam tes. Mulut meyakinkan tidak membuktikan terjemahan benar.
Pisahkan izin suara dan rupa
Seseorang mungkin mengizinkan foto ditampilkan tanpa menyetujui ucapan baru dikaitkan dengannya. Pengisi suara dapat melisensikan rekaman tanpa mengizinkan klon. Tulis tujuan, distribusi, durasi, dan cakupan komersial sebelum membuat untuk klien.
Untuk klon dikenali, dapatkan izin tegas orang tersebut atau pemegang hak berwenang. Simpan persetujuan dengan sumber dan kontak koreksi atau penarikan. Jangan mengesankan ucapan buatan adalah rekaman nyata.
Periksa juga ketentuan dan praktik data alat. Alat browser biasanya mengunggah berkas; penghapusan atau pelatihan bisa berbeda per paket. Untuk pekerjaan sensitif atau berbayar, baca keamanan unggah wajah, pelatihan dan retensi, penggunaan komersial.
Perbaiki tahap yang gagal
Jika nama produk salah, revisi atau buat ulang suara. Jika jelas tapi terlalu cepat, pendekkan naskah atau gunakan kontrol tempo yang didukung. Jika wajah berubah atau gigi berkedip, periksa gambar dan model visual.
Jika mulut bergerak saat jeda, simpan penanda waktu dan cek pengaturan waktu atau model. Jika kata terakhir terpotong, bandingkan durasi audio, klip terkirim, dan ekspor. Jangan ubah banyak variabel sekaligus karena menyamarkan perbaikan yang membantu.
Tes singkat membuat pekerjaan terkendali. Simpan percobaan ditolak sebagai bukti serta rekaman dan pengaturan diterima. Untuk proyek lebih besar, daftar generator membantu mencari jalur lain tanpa mengulang seluruh proses naskah.
Pertanyaan umum
Bisakah membuat foto berbicara dari teks tanpa mikrofon?
Ya. Buat suara sintetis berlisensi dari naskah, lalu animasikan foto dengan audio atau input teks terintegrasi.
Apakah harus mengkloning suara sendiri?
Tidak. Suara stok atau rancangan bisa dipakai. Kloning opsional dan memerlukan izin serta fitur tersendiri.
Bisakah memasukkan SSML ke semua kotak teks?
Tidak. Pakai SSML atau tag hanya jika mesin dan model tepat mendokumentasikannya. Jika tidak, mulai dengan teks dan tanda baca biasa.
Apakah terjemahan mempertahankan waktu yang sama?
Belum tentu. Bahasa berbeda panjang dan ritmenya. Setujui adaptasi yang enak diucapkan dan ukur audio sebelum membuat wajah.
Apakah wajah realistis membuat suara lebih alami?
Bisa memengaruhi kesan, tetapi tidak memperbaiki pelafalan atau tempo. Dengarkan audio sendiri sebelum animasi.
Setujui dua kalimat sebelum menganimasikan
Tulis pesan singkat dengan nama dan angka sebenarnya yang diperlukan audiens. Bawa ke alat foto berbicara, dengarkan suara dan buat klip potret hanya setelah audio mengatakan maksud Anda dengan tepat.
Riwayat
- 2026-10-25: Diperiksa jalur resmi teks, audio, gambar dan bahasa TTS per model. Ditambahkan contoh lisan, panduan SSML bersyarat, dan pengecekan izin suara serta rupa terpisah.