
Laat een foto praten met tekst-naar-spraak: zonder microfoon
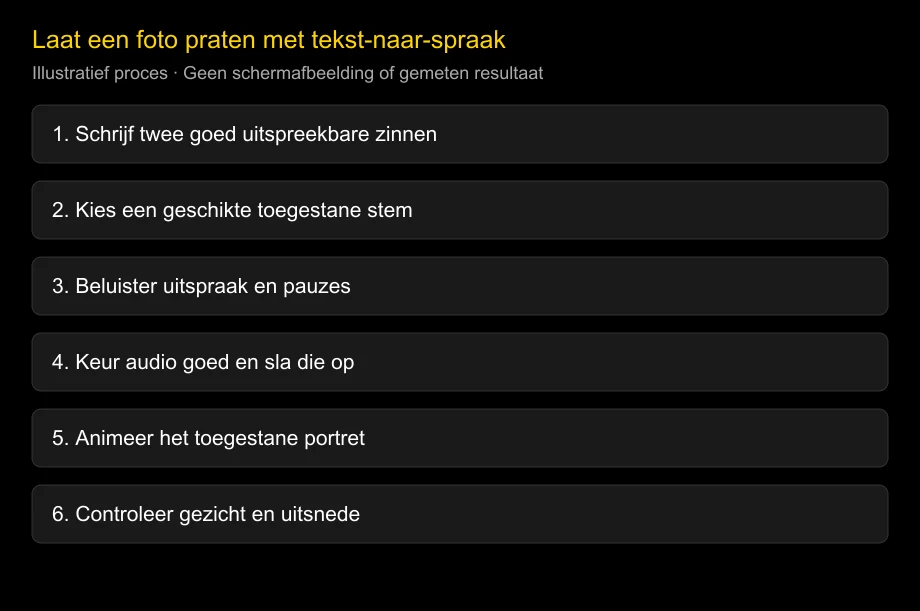
Ja, je kunt een foto laten praten met tekst-naar-spraak zonder jezelf op te nemen. Schrijf het script, genereer en keur een gelicentieerde stem goed en gebruik dat geluid in een beeld-naar-praatvideo-tool. Sommige platforms combineren de drie stappen, maar eerst de stem controleren voorkomt onnodig opnieuw genereren van het gezicht.
Gecontroleerd: 2026-10-25. Deze gids bekijkt officiële beschrijvingen van D-ID, HeyGen, Sync en ElevenLabs. Talen en pauzecontroles zijn afhankelijk van het gekozen stemmodel, niet van een algemene bedrijfsclaim.
De betrouwbare volgorde is script, stem, gezicht. Een goed gesynchroniseerde mond kan verkeerd uitspreken. Keur daarom het geluid goed voordat je de animatie beoordeelt.
Wat je vooraf nodig hebt
Bereid een toegestaan portret, kort script en voor het doel bruikbare stem voor. Een duidelijk frontaal gezicht met vrije mond is een goede eerste proef. Houd de hele kin en voldoende ruimte voor de definitieve uitsnede.
Gewone tekst-naar-spraak vereist geen microfoon. Stemklonen is optioneel en vraagt extra toestemming. Een bestaande of ontworpen stem kan passen als je geen specifieke persoon hoeft na te bootsen.
Bewaar bronbeeld, tekst, definitief geluid en instellingen samen. Verandert de tekst, sla dan een nieuwe audioversie op in plaats van de oude te overschrijven. Zo voorkom je nieuwe ondertitels bij een oude opname.
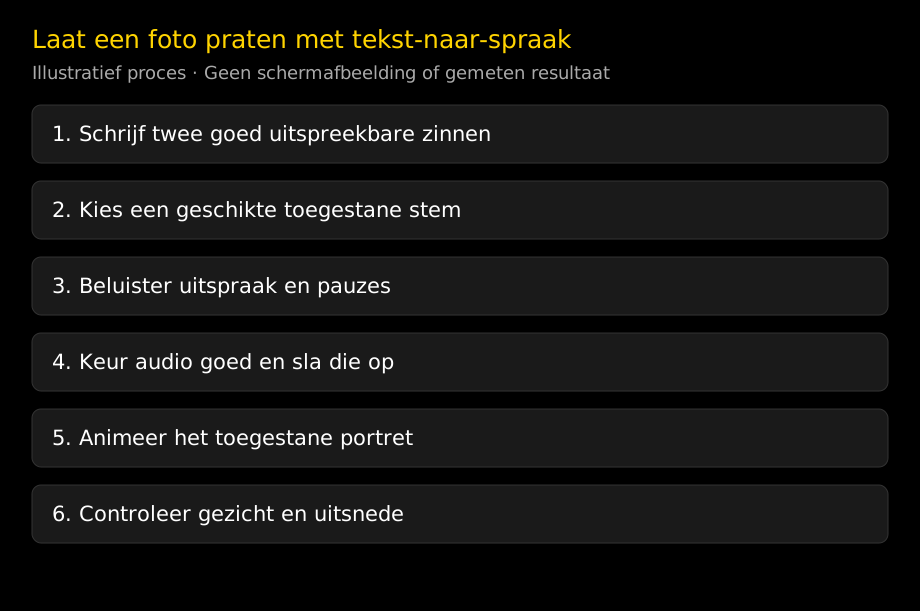
Laat de foto in drie stappen praten
1. Schrijf voor luisteren in plaats van lezen
Gebruik één idee per zin en zet de belangrijkste handeling vooraan. Lees hardop, ook als een synthetische stem het gaat zeggen. Als jij moet stoppen om de tekst te begrijpen, moet de luisteraar dat vermoedelijk ook.
Twee korte zinnen zijn een goed eerste script. Bijvoorbeeld: “Welkom in de werkruimte. Open je checklist en kies de eerste taak.” Dit is een origineel tekstvoorbeeld, geen opgenomen productresultaat.
Schrijf getallen of afkortingen voluit wanneer de stem ze verkeerd leest. Test echte merk- en persoonsnamen voordat je het hele script schrijft. Een stem met goed alledaags Engels kan moeite hebben met productnamen of gemengde talen.
2. Genereer en keur de stem goed
Kies een stem voor publiek en taal. Luister zonder naar een gezicht te kijken. Controleer uitspraak, tempo, emotie en het laatste woord en wijzig daarna tekst of ondersteunde steminstellingen.
Sla goedgekeurde audio op vóór de animatie. Heeft een geïntegreerd platform een stemvoorbeeld, gebruik het. Begin anders kort, zodat een kleine tekstcorrectie geen hele lange video opnieuw vereist.
3. Animeer het portret en controleer de export
Upload het goedgekeurde geluid in een fotoanimatiewerkwijze of gebruik de ondersteunde tekstinvoer. Controleer model, geoffreerde duur, uitsnede en exportvoorwaarden. Bewaar de instellingen bij de bronnen.
Bekijk op normale snelheid. Controleer eerste zin, pauzes en laatste sluiting en daarna het hele gezicht en de hals. Verandert de identiteit, probeer een helderdere bron of andere route in plaats van de stem de schuld te geven.
Verbeter commerciële tekst vóór het genereren
Vergelijk deze eigen voorbeelden:
| Concept | Gesproken versie | Waarom dat helpt |
|---|---|---|
| Ons platform maakt brede workflowoptimalisatie mogelijk. | Zet de volgende teamtaak in één gedeelde checklist. | Geeft een concrete handeling |
| Navigeer naar het instellingengedeelte om door te gaan. | Open instellingen. Kies daarna je taal. | Maakt een duidelijke zinsgrens |
| Bespaar 20% vóór 10/31. | Bespaar twintig procent vóór eenendertig oktober. | Vermindert dubbelzinnig lezen van getallen |
Dit zijn schrijfvoorbeelden, geen eis dat elke stem uitgeschreven getallen nodig heeft. Beluister de echte uitvoer en houd de versie die duidelijk en natuurlijk de juiste betekenis overbrengt.
Gebruik bij een korte productintro drie delen: wie het helpt, de directe taak en de volgende actie. Bijvoorbeeld: “Beheer je een kleine klas? Verzamel de leschecklist op één plek. Open het sjabloon en voeg de eerste activiteit toe.” Houd het portret kort genoeg om de productdemonstratie de details te laten uitleggen.
Heb je al een afgeronde opname, sla TTS dan over en gebruik het bestand in de pratende-fototool. Het doel is de stem goedkeuren, niet elk project tot spraaksynthese dwingen.
Hoe voeg je pauzes toe?
Begin met normale leestekens. Een punt geeft meestal een sterkere grens dan een komma, al hangt de uitvoering van het model af. Korte zinnen zijn makkelijker te wijzigen dan een lange regel vol pauzemarkeringen.
Sommige engines ondersteunen SSML-pauzes, audiotags of andere controles. De syntaxis is niet automatisch uitwisselbaar. Een opdracht voor het ene model kan bij een ander genegeerd of hardop gelezen worden.
ElevenLabs’ TTS-documentatie onderscheidt modellen en mogelijkheden. Lees het exacte model voordat je tags toevoegt. Ondersteunt het een eigen pauzecontrole, beluister dan een korte proef en bewaar het geaccepteerde resultaat.
“Open instellingen. Kies daarna je taal.” is bijvoorbeeld een bruikbaar begin met gewone tekst. Een tag als <break time="500ms"/> past alleen bij een engine die die SSML-syntaxis expliciet ondersteunt. Dit vraagt een halve seconde pauze en is geen universele opdracht.
Welke gereedschapsroute kies je?
| Uitgangssituatie | Te onderzoeken route | Belangrijkste grens |
|---|---|---|
| Script en portret, geen opname | Geïntegreerde tekst naar pratende foto | Beluister de stem en controleer het model |
| Goedgekeurde externe TTS-audio | Audio-upload in fototool | Behoud exacte timing en stemrechten |
| Herkenbare persoonlijke stem nodig | Toegestane kloon met fotoanimatie | Regel stem- en portrettoestemming apart |
| Meerdere talen nodig | Door moedertaalsprekers gecontroleerde tekst en taalstemmen | Beschikbaarheid bewijst geen gelijke kwaliteit |
D-ID’s Studio-pagina beschrijft tekst, audio en stilstaande beelden voor avatarvideo’s. HeyGens lipsynchronisatiepagina bevat getypte scripts en fotoavatars naast videoroutes. Syncs beeldgids beschrijft tekst- en stemkeuzes voor sync-3.
Deze officiële uitleg rechtvaardigt onderzoek naar de route, geen vergelijking van realisme. Openbaarmaking: LipSyncX publiceert dit artikel en biedt een commerciële fotoanimatieroute. Er wordt geen onafhankelijke ranglijst met identieke invoer geclaimd.
Wat betekenen de aantallen talen?
Taalondersteuning is modelgebonden. De op 25 oktober 2026 bekeken ElevenLabs-documentatie noemt 32 talen voor Flash v2.5 en 29 voor Multilingual v2; nieuwere families hebben andere totalen. Noteer het model in plaats van elke stem de grootste advertentiedekking toe te kennen.
Hetzelfde geldt voor videoplatforms. Een taal voor geüploade audio, vertaling of een standaardstem bestaat mogelijk niet in elke kloon- of avatarmodus. Controleer de combinatie in het echte proces.
Laat bij meerdere talen een moedertaalspreker de tekst goedkeuren en het geluid beluisteren. Neem namen, datums en vaktermen in de proef op. Een aannemelijke mond bewijst geen correcte vertaling.
Scheid toestemming voor stem en portret
Iemand kan toestemming voor de foto geven zonder nieuwe uitspraken op eigen naam goed te keuren. Een stemacteur kan een opname licentiëren zonder een kloon toe te staan. Noteer doel, distributie, duur en commerciële reikwijdte voordat je voor een klant genereert.
Vraag voor een herkenbare stemkloon expliciete toestemming van de persoon of bevoegde rechthebbende. Bewaar die met bronnen en een contactpersoon voor correctie of intrekking. Wek niet de indruk dat een gegenereerde uitspraak echt is opgenomen.
Controleer ook voorwaarden en gegevenspraktijk. Browsertools uploaden meestal bestanden; verwijder- en trainingsregels kunnen per abonnement verschillen. Zie bij gevoelig of betaald werk de gidsen over veilige gezichtsuploads, training en bewaring en commercieel gebruik.
Los de mislukte fase op
Klopt de productnaam niet, wijzig of genereer de stem opnieuw. Is de stem helder maar te snel, verkort de tekst of gebruik ondersteunde tempocontrole. Verandert het gezicht of flikkeren de tanden, bekijk bronbeeld en visueel model.
Beweegt de mond in een pauze, noteer de tijd en controleer timing of modelinstellingen. Ontbreekt het laatste woord, vergelijk audiolengte, ingestuurde clip en export. Verander niet meerdere variabelen tegelijk; dan weet je niet wat hielp.
Een korte proef houdt dit beheersbaar. Bewaar afgewezen pogingen als bewijs en houd goedgekeurde opname en instellingen bij. Voor grote projecten helpt de generatorselectie een andere route te vinden zonder het hele schrijfproces over te doen.
Veelgestelde vragen
Kan ik zonder microfoon een foto laten praten met tekst-naar-spraak?
Ja. Genereer een gelicentieerde synthetische stem uit tekst en animeer het beeld met dat geluid of geïntegreerde tekstinvoer.
Moet ik mijn stem klonen?
Nee. Bestaande of ontworpen stemmen kunnen werken. Klonen is optioneel en vraagt aparte toestemming en ondersteuning.
Mag SSML in elk tekstvak?
Nee. Gebruik SSML of audiotags alleen als de exacte engine en het model ze documenteren. Begin anders met gewone taal en leestekens.
Blijft de timing gelijk na vertalen?
Niet noodzakelijk. Talen verschillen in lengte en tempo. Keur een goed uitspreekbare bewerking goed en meet audio vóór het gezicht.
Maakt een realistisch gezicht de stem natuurlijker?
Het kan je indruk beïnvloeden maar herstelt uitspraak of tempo niet. Luister eerst alleen naar het geluid.
Keur twee zinnen goed vóór de animatie
Schrijf een korte boodschap met de echte namen en getallen die nodig zijn. Breng die naar de pratende-fototool, beluister de stem en genereer pas wanneer het geluid precies de bedoeling zegt.
Wijzigingslog
- 2026-10-25: Officiële tekst-, audio- en beeldroutes en modelgebonden TTS-talen gecontroleerd. Spreektekstvoorbeelden, voorwaardelijke SSML-uitleg en aparte toestemmingscontroles voor stem en portret toegevoegd.